Soy un usuario habitual de los servicios de Google: el buscador y Gmail son dos de los que más frecuentemente utilizo en mis sesiones en Internet, pero hay muchos más. Y por supuesto seguro que vosotros también hacéis uso de dichas ofertas, que Google ofrece gratuitamente y que normalmente ofrecen prestaciones notables.


Sin embargo existen muchas alternativas en este segmento de los servicios web, y algunas de ellas son soluciones desarrolladas con la filosofía Open Source. En Datamation han redactado un interesante artículo en el que es posible comprobar que en muchos casos es posible prescindir de Google y utilizar dichas herramientas, tanto en sus servicios web como en sus aplicaciones de escritorio.
Los motivos pueden ser muchos: las sospechas sobre la recolección de nuestros datos y una potencial invasión de la privacidad es probablemente la mayor de ellas. Sea cual sea la vuestra, he aquí una lista de las posibilidades:
Índice:
1. Chrome y la alternativa de Iron.
2. Buscador Google y la alternativa de DuckDuckGo (no es un buscador Open Source, pero al menos no registra tus movimientos) y de Yacy, que si es de código abierto y no registra tus movimientos.
3.
Gmail y la alternativa de Roundcube.
4.
Google Reader y la alternativa de Newsblur.
5.
Google Talk y la alternativa de Ekiga.
6.
Google Docs y la alternativa de TeamDrive extensión para OpenOffice (y suponemos que en el futuro para LibreOffice)
7.
Picasa y la alternativa de DigiKam.
1.
Chrome - Alternativa Iron
SRWare Iron, o simplemente Iron, es un navegador web basado en Chromium, principalmente enfocado a eliminar el seguimiento o rastreo de uso (usage tracking, en inglés) que el navegador Google Chrome incluye. SRWare Iron es software libre y de código abierto (FLOSS).
Iron incluye notables características únicas. En contraste con Chrome, implementa la última versión de WebKit (motor de renderizado), e incluye una función de bloqueo o filtro de anuncios web. Una especulación común es que la característica de bloqueo de anuncios en Chrome no estará nunca realizada completamente porque excluiría los anuncios incluidos por Google en las respuestas a las búsquedas
Historia del desarrollo
Iron fue lanzado por primera vez el 18 de septiembre de 2008, 16 días después de la publicación inicial de Chrome. De acuerdo a los desarrolladores de Iron, El código fuente de Chromium fue ampliamente modificado con el fin de eliminar cualquier seguimiento de la funcionalidad relacionada. El 22 de enero de 2009, fue liberada una versión de desarrollo.
Las versiones más recientes de Iron desde que ha sido liberado, han adquirido las características del código de base subyacente de Chrome, incluyendo soporte para temas, la posibilidad de cambio de agente de usuario, un sistema de extensiones, y soporte mejorado para Linux.
El 7 de enero de 2010 se publicó la primera versión para Mac OS X.
Diferencias con Chrome:
Las siguientes funciones de Google Chrome se han eliminado o desactivado en Iron:
* RLZ identifier: Una cadena codificada enviada junto con todas las consultas a Google o cada 24 horas.
* No tiene como página de inicio por defecto la página de búsqueda de Google, como motor de búsqueda predeterminado
* Un identificador (ID) único ("clientID" para identificar al usuario en los registros de accesos.
* Una Marca de tiempo (Timestamp) de cuando fue instalado el navegador.
* Páginas de error alojadas en servidores de Google, cuando no se encuentra un servidor.
* Instalación automática de "Google Updater".
* DNS "pre-fetching".
* sugerencias automáticas de búsquedas en la Barra de direcciones.
* Sistema de seguimiento de errores que envía información sobre cuelgues del navegador o errores.
2.
Buscador Google – DuckDuckGo (no es un buscador Open Source, pero al menos no registra tus movimientos)
Google siempre ha sido criticado porque se dice que guarda nuestros datos, desde cuando hacemos una búsqueda, hacemos un clic en algún anuncio, vemos algún video, buscamos alguna dirección, enviamos algún correo electrónico, etc, etc.
Y “agarrándose” de esto, ha salido DuckDuckGo, un buscado web que asegura que ellos no rastrean ni guardan nuestra información. La gente de DuckDuckGo esta enfocada en la privacidad y su publico objetivo son todas las personas que se preocupan a morir por la privacidad de sus datos.
Pero seamos sinceros y démonos cuenta de que la seguridad y protección de nuestra información y nuestros datos depende de nosotros, de nadie mas. Nosotros somos los responsables de cuidar lo que compartimos en la web.
No estoy defiendo a Google, pero si quiero recomendarles que seamos un poco mas conscientes de nuestras propias actividades en Internet, muchos han (hemos) pasado por amargas experiencias que nos han hecho escarmentar.
Yacy
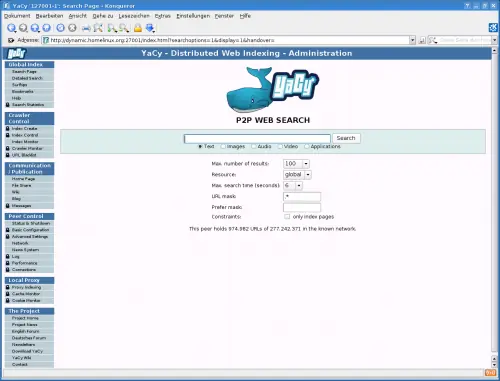
Con el inesperado cierre de Wikia Search, se hace necesario buscar alternativas a los buscadores privativos y monopólicos como Google o MSN Search. Yacy es una de ellas y es quizá la mejor, nos permite navegar anónimamente y sin censura.
¿Por qué? Porque YaCy funciona desde hace bastante tiempo y con la filosofía de las redes P2P, tal como lo hacen los conocidos clientes Emule o Ares para intercambiar archivos, YaCy se encarga de las búsquedas en Internet.
En http://141.52.175.50:8080/ podemos hacer una prueba gracias al Sciencenet @ LiebelLab, pero existen muchas otras computadoras en el mundo corriendo YaCy, compartiendo información y recursos.
Aquí hay una lista completa de todas ellas: http://www.yacyweb.de/peers.htm
Cada máquina que corre Yacy es un “peer”, o “par”, si existieran millones de Yacys instalados podríamos superar con creces la capacidad de procesamiento de Google y así tiraríamos abajo lo que ahora se ve como un gigante todopoderoso.
Hay que tener en cuenta que hace unos años pensábamos que era casi imposible doblegar al Internet Explorer, hoy en día cualquier usuario más o menos informado usa el Software Libre Firefox; hace unos años nadie pensaba que la enciclopedia privativa Encarta moriría en manos de la libre Wikipedia, hoy en día el software libre y su filosofía de colaboración online se encuentran triunfando e incluso representa el puntal de innovación en la industria TI según la consultora Forrester.
Volvamos a Yacy: podemos usar este buscador P2P a diario más fácilmente si lo sumamos como predeterminado en los motores de búsqueda de Firefox u otro navegador libre. En el caso de Firefox desplegaremos la lista y elegiremos “Añadir YaCy Search on (nombre del servicio)”, de tal forma en vez de buscar por Google buscaremos en YaCy y aprenderemos a ver Internet de otra manera.
Probando varios peers, he llegado a la conclusión de que http://yacy.dyndns.org:8000/ es el mejor de todos en materia de velocidad de respuesta, cantidad de contenido almacenado y conexión con otros peers.
Nuestras mentes están tan colonizadas por la visión que tiene Google del mundo que al principio será extraño el sentimiento de usar otro buscador, pero el futuro de la libertad de expresión, de pensamiento y de construcción del conocimiento en Internet dependerán también de ello.
¿Qué es lo que falta? Al menos veo 2 cosas:
* Que muchas otras personas, además se usar YaCy, lo instalen en su PC y así colaboren con recursos de procesamiento.
* Crear un dominio con un nombre corto y fácil de recordar que redireccione hacia el mejor peer o tenga instalado YaCy conectado a todos los peers existentes.
¿Alguien se anima?
Cosas que vale la pena saber al comenzar a usar Yacy
No soy un experto en Yacy. Este texto contiene algunos consejos para que Yacy no consuma tantos recursos en nuestro sistema que he aprendido en la práctica. A continuación explico algunas cosas que tuve que aprender al usar Yacy, el buscador p2p. Por ejemplo, cómo configurar Yacy para que no consuma tantos recursos de RAM y procesador y podamos realizar otras actividades sin apagar el buscador. También explicaré como configurar el proxy con Yacy e indexar páginas mientras navegamos, además de algunos consejos sobre cómo crawling (recolectar?) urls sin “atascar nuestro pc”.
1. Configurar el uso de RAM en Yacy
En los menus de la izquierda debemos hace clic en “Admin Console”, luego en el menú de arriba en “Performance”.La primera casilla dice “Memory Setting” por defecto viene 600 mbs de memoria. Esto es demasiado para PCs con 1GB o menos de RAM. Es recomendable introducir un valor menor (yo probé con 200 mbs), lo cual reducirá el rendimiento de Yacy pero dejará más espacio libre para otros procesos. Luego haces clic en “set” para aplicar el cambio.
2. Configurar el porcentaje que se utiliza para crawling (recolectar?)de la performance definida
En la misma sección de “Perfomance”, más abajo dice “Use Default Profile”. Recomiendo para PCs de escritorio o notebooks seleccionar valores como 25% o 10%. Esto mejora el rendimiento de tu computador mientras usas Yacy. Clic en “Save” para aplicar la configuración (se debe reiniciar Yacy).
3. Configurar las cantidad de páginas que se procesan por minuto
El proceso de crawling (que yo traduciría por recolección) de urls consume muchos recursos del procesador. Para reducir la cantidad de páginas por minuto hacemos clic en “Crawler Monitor” ubicado en el menú izquierdo de Yacy. Uno de los cuadros desplegados dice “Speed”, en aquella sección haz clic en el botón “minimun” para ordenar a Yacy que recolecte solo 10 páginas por minuto. Esto dará un respiro a tu Pc. Puedes aumentar el valor según la potencia de tu Pc o si te dedicas exclusivamente a Yacy.
4. Crawling (recolectar?) urls en forma manual
Para crawling/recolectar urls e indexarlos local y remotamente (hacia otros peers de Yacy) en forma manual conviene hacerlo desde “Crawl Start Expert”. Para ellos hacemos clic en “Index Creation” ubicado en el menú izquierdo, luego en el menú superior buscamos “Crawl Start Expert”. En “Starting Point” se introduce el url inicial, desde donde comenzará nuestra recolección. En Crawling Depth (profundidad) se debe introducir un valor. El valor 0 significa que se recolectará sólo el url de partida. Entre más profundo (más alto el número) más urls del sitio recolectará, lo cual toma más tiempo y más recursos. Elige el valor que más te convenga y según la importancia que le concedes al sitio y a sus páginas interiores. Luego puedes ver otras opciones como “Maximun Pages per Domain”, opción que permite limitar el número de páginas que se recolectan por sitio, y otras opciones que no explicaré aquí. La opción importante de marcar es “Do remote indexing”, la cual permite que lo que recolectas sea indexado en otros peer también. Para iniciar la recolección, haces clic en “Star New Crawl” y comenzará el proceso.
5. Crawling (recolectar?) urls mientras navegas
Para recolectar e indexar urls mientras navegas Yacy ofrece un proxy. Para emplearlo debes configurar tu navegador. Si usas Firefox esto se hace en “Editar” luego en “Preferencias” luego en “Avanzado” luego en la pestaña “Red” luego en “Configuración” y se abrirá la ventana “Configuración de conexión”. En la ventana seleccionas “Configuración manual de proxy”. En la caja que dice “Proxy HTTP” introduces “localhost” y donde dice “Puerto” introduces “8080”. Seleccionas la casilla usar mismo proxy para todo. Para no tener problemas al ingresar a algunas páginas, más abajo donde dice “No usar proxy para” introduces las excepciones separadas por coma. Por ejemplo: gmail.com,gnewbook.org De esta forma no se usará el proxy al ingresar a esas páginas que requieren autenticar. Una ves hecho esto, y si Yacy está encendido, recolectará en indexara las páginas que abras en tu navegador. El proxy funciona por defecto en profundidad 0 por lo que no atascará tu computador. Importante: si Yacy está apagado, no podrás navegar con este proxy.
Espero que estos consejos te hayan servido para usar Yacy sin consumir todos los recursos de tu computador. Saludos.
3.
Gmail y la alternativa de Roundcube.
Si necesitáis ofrecer un cliente de email en vuestra empresa, Roundcube puede ser una buena solución, gratuita y de código abierto.
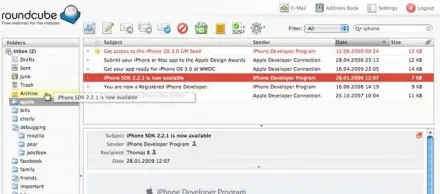
Entre otras cosas puede configurarse en varios idiomas, soporta HTML, tiene agenda de contactos, dispone de un motor de búsqueda de mensajes, tiene gestión de directorios IMAP, corrector ortográfico y API, con lo que no tiene nada que envidiar a otros clientes de correo más utilizados y no gratuitos.
Funciona con Php y Mysql y podéis ver más capturas en roundcube.net/screens.
Round Cube es otro webmail con licencia GPL y soporte multilenguaje. Además incluye IMAP, soporte para MIME, incorpora libreta de direcciones, permite la manipulación de carpetas, posee búsqueda de mensajes y corrector ortográfico.
Este está escrito en PHP y hace uso de MySQL o Postgres. Su interfase soporta skin y usa XHTML y CSS2.
Llevo algunos años usándolo ya que viene instalado en los servicios de hosting que vendo y la verdad es que funciona muy bien, la interfase es bastante moderna, agradable y funcional. No es que me vuelva loco, pero muchas veces las opciones de webmail que encontramos en los hosting son lamentables y Round Cube brinda un entorno agradable, una experiencia de usuario amena y todas las funcionalidades que se necesitan cuando hay que consultar el correo desde el navegador.
4.
Google Reader y la alternativa de Newsblur.
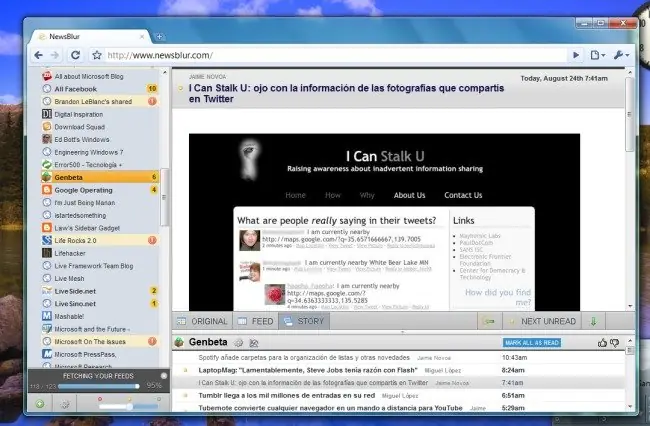
Todos ya sabemos que Google Reader es quien tiene el liderazgo casi absoluto en el terreno de los lectores de feeds. No hay muchas alternativas, y la mayoría de ellas no le llegan ni a los talones (ni en cantidad de usuarios ni en funcionalidades). Y las pocas que sí lo hacen, como FeedDemon, se sincronizan con el mismo Google Reader, por lo que de todas formas tenemos que pasar por la compañía de la gran G.
Por eso NewsBlur es un lector RSS digno de destacar, ya que está a la altura del producto de Google, y a la vez es totalmente independiente de este (no necesitamos una cuenta Google para usarlo).
Pero, ¿Que ventajas nos ofrece NewsBlur por sobre Google Reader de toda la vida? Principalmente, que posee un sistema de recomendación y filtros muy bien implementado. Se nos da la opción de “votar” cada noticia que leamos, y especificar qué nos gusta/interesa de ella, si es el blog donde fue publicada, el autor que la redactó, o el tag/categoría asociado al post.
De ese modo, si por ejemplo nos gustan los posts de Alkar en Genbeta, o de Joshua Topolsky en Engadget, NewsBlur identificará automáticamente este patrón y empezará a destacar estos posts para que los tengamos más a la mano. Inclusive, el lector detecta las palabras clave, tags, o categorías más comunes entre los posts que nos gustan.
Asimismo, si nos desagradan los post de cierto editor, o si estamos aburridos de los artículos sobre cierto tema podemos especificar que no nos gustan y también se creará un patrón a partir de eso.
¿Y qué ganamos con todo eso? Pues que NewsBlur empezará a clasificar automáticamente los nuevos feeds entre interesantes, normales, y poco interesantes, a partir de los criterios ya entregados. De ese modo, si andamos con poco tiempo, podemos leer solo los feeds seleccionados por NewsBlur, y dejar de lado aquellos que traten sobre temas que no nos interesen.
Pero eso no es todo, ya que hay otras opciones que ya están en Google Reader, pero que NewsBlur las implementa mejor. Por ejemplo, en el lector de Google se puede , pero en NewsBlur se puede elegir la fecha tope de forma más granular. También deja acceder a la página original del post sin salir del lector, y ofrece estadísticas más completas que Google Reader. Además, la interfaz de NewsBlur es tremendamente rápida y atractiva visualmente. Y por si fuera poco, están a punto de lanzar una aplicación para iPhone que se se sincronizará con el lector web-based.
Desgraciadamente, hay unas cuantas cosas que NewsBlur se deja en el tintero y que quizás muchos de ustedes echen de menos. Por ejemplo, no permite leer los feeds agrupados por carpetas (deja ordenarlos en carpetas, pero obliga a leer los feeds de uno en uno).
Para sacarle el jugo a NewsBlur debemos crearnos una cuenta y agregar los feeds, pero esto tampoco es mucho problema, ya que podemos importar toda la configuración de Google Reader con tan solo ingresar con nuestra cuenta de Google.
5.
Google Talk y la alternativa de Ekiga.
Ekiga, anteriormente llamado GnomeMeeting, es una aplicación de software libre para realizar videoconferencias y telefonía IP para GNOME. Usa el hardware o software compatible con H.323 (como Microsoft Netmeeting) y se libera bajo licencia GPL. Además está disponible para sistemas Unix y Windows.
Permite todas las características modernas de una videoconferencia como soporte de proveedor inteligente o llamadas de telefonía desde el ordenador a un teléfono.
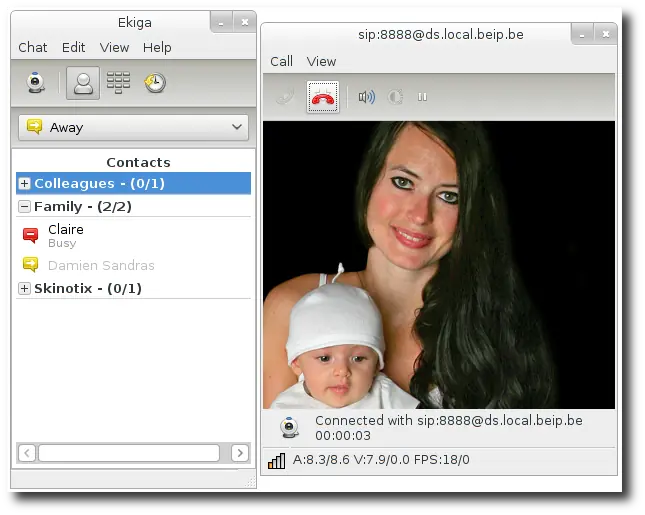
Para su correcto funcionamiento debe disponerse de una cuentas SIP, que puede crearse gratuitamente desde [2]. Por otro lado para poder realizar llamadas a teléfonos convencionales desde el PC se debe disponer de una cuenta con algún servidor de telefonía por internet. El mismo programa recomienda el proveedor Diamondcard Worldwide Communication Service, si bien existen muchos otros como VoIPBuster. Estos servicios no son gratuitos sino que se paga al proveedor del servicio en función del teléfono de destino según
sus tarifas.
6.
Google Docs y la alternativa de TeamDrive extensión para OpenOffice (y suponemos que en el futuro para LibreOffice)
7.
Picasa y la alternativa de DigiKam.
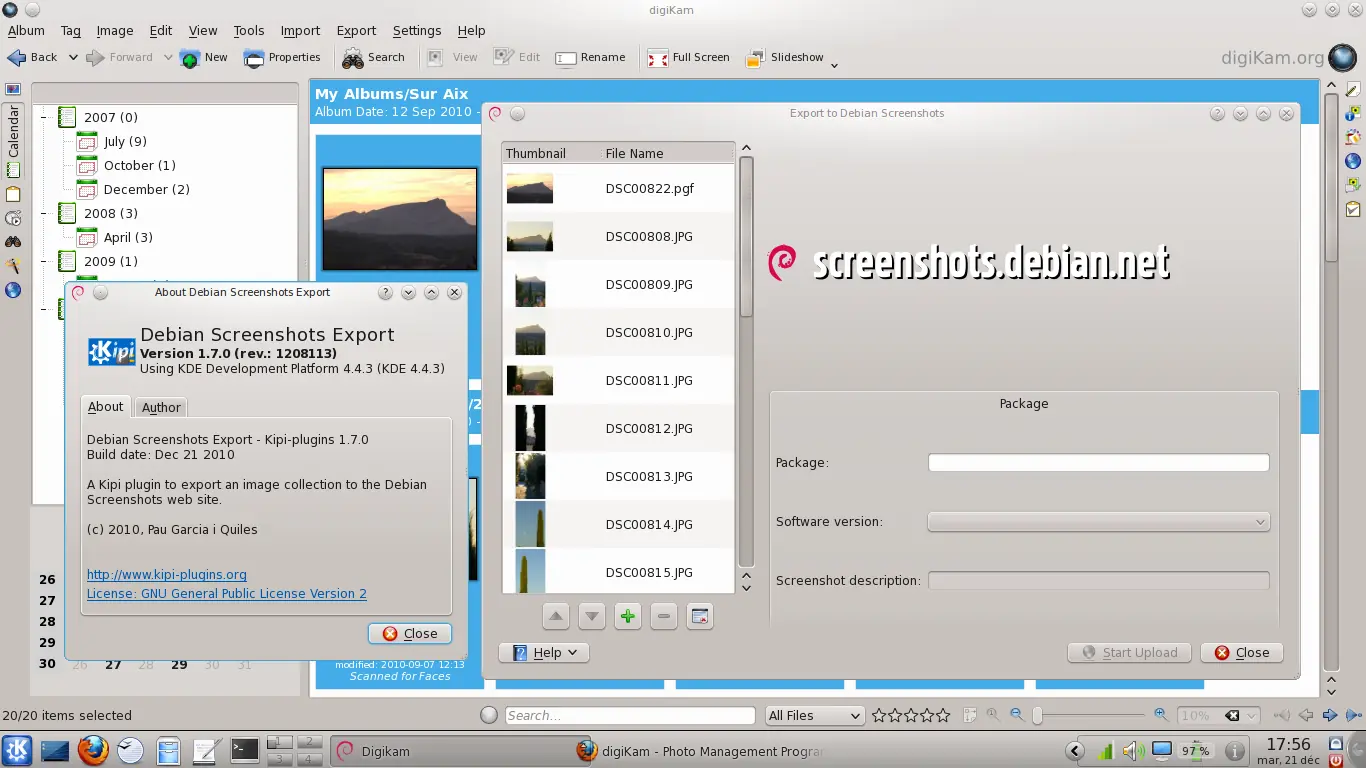
DigiKam es un potente gestor fotográfico que viene desde Linux con una batería de herramientas y funcionalidades que harán las delicias tanto de aficionados y profesionales de la fotografía.
Con DigiKam podrás organizar tus imágenes, asignarles etiquetas, editar sus metadatos e ítems de geolocalización, corregir errores o problemas de luz y de color, ver tu colección como una presentación o importar y exportar fotos en Flickr, Piwigo, Picasa, Facebook o SmugMug, entre otros.
El único defecto de DigiKam es su mejorable integración con Windows, que produce en ocasiones problemas para añadir imágenes o abrir carpetas del disco.
Digikam es un gestor de álbumes de foto fresco, sutil y muy completo con sus funciones de edición básica y extensa colección de añadidos gracias al uso del sistema nativo de plug-ins Kipi. Con Digikam podrás importar y organizar tus fotos en álbumes, por fecho pero también mediante la creación de etiquetas.
Hoy en día el uso de etiquetas se está popularizando bastante. Son palabras claves que se asignan a cada imagen para describirla, unas etiquetas que aprovecharemos para navegar de forma más ingeniosa por nuestra librería, algo muy similar al servicio de álbumes online Flickr.
Digikam permite crear álbumes de fotos y organizarlos cronológicamente, pero también usar el modo de edición para retocar nuestras imágenes con gran facilidad. Con Digikam podrás añadir comentarios y disfrutar de añadidos muy variados gracias al subsistema Kipi, como por ejemplo la función de ojos rojos, filtros de imágenes o efectos especiales.
Página de Iron:
www.srware.net/en/software_srware_iron.php
Página de DuckDuckGo:
http://duckduckgo.com
Página de Newblur:
http://www.newsblur.com/
Página de Roundcube:
http://www.roundcube.net/
Fuentes:
http://www.muylinux.com/2011/02/17/alternativas-open-source-a-los-servicios-de-google/
http://es.wikipedia.org/wiki/Ekiga
http://es.wikipedia.org/wiki/SRWare_Iron
http://miguelalejoescritor.wordpress.com/2010/11/08/configurar-yacy-para-un-buen-desempeno/
http://www.genbeta.com/web/newsblur-una-excelente-alternativa-a-google-reader-que-filtra-los-posts-mas-relevantes
http://www.tendenciadigital.com.ar/index.php/linux/linux-novedades/digikam-1.8.0-organiza-visualiza-y-edita-tus-fotos-en-kde.html
http://www.idiomalibre.com/internet/yacy-buscador-software.php
http://wwwhatsnew.com/2010/02/26/roundcube-un-webmail-para-instalar-en-tu-servidor/
http://zonalinux.com.ar/round-cube-cliente-webmail-muy-completo-y-con-licencia-gpl/
http://www.esmeraldasonline.com/duckduckgo-vs-google-privacidad.html
Sin embargo existen muchas alternativas en este segmento de los servicios web, y algunas de ellas son soluciones desarrolladas con la filosofía Open Source. En Datamation han redactado un interesante artículo en el que es posible comprobar que en muchos casos es posible prescindir de Google y utilizar dichas herramientas, tanto en sus servicios web como en sus aplicaciones de escritorio.
Los motivos pueden ser muchos: las sospechas sobre la recolección de nuestros datos y una potencial invasión de la privacidad es probablemente la mayor de ellas. Sea cual sea la vuestra, he aquí una lista de las posibilidades:
Índice:
1. Chrome y la alternativa de Iron.
2. Buscador Google y la alternativa de DuckDuckGo (no es un buscador Open Source, pero al menos no registra tus movimientos) y de Yacy, que si es de código abierto y no registra tus movimientos.
3.
Gmail y la alternativa de Roundcube.
4.
Google Reader y la alternativa de Newsblur.
5.
Google Talk y la alternativa de Ekiga.
6.
Google Docs y la alternativa de TeamDrive extensión para OpenOffice (y suponemos que en el futuro para LibreOffice)
7.
Picasa y la alternativa de DigiKam.
1.
Chrome - Alternativa Iron
SRWare Iron, o simplemente Iron, es un navegador web basado en Chromium, principalmente enfocado a eliminar el seguimiento o rastreo de uso (usage tracking, en inglés) que el navegador Google Chrome incluye. SRWare Iron es software libre y de código abierto (FLOSS).
Iron incluye notables características únicas. En contraste con Chrome, implementa la última versión de WebKit (motor de renderizado), e incluye una función de bloqueo o filtro de anuncios web. Una especulación común es que la característica de bloqueo de anuncios en Chrome no estará nunca realizada completamente porque excluiría los anuncios incluidos por Google en las respuestas a las búsquedas
Historia del desarrollo
Iron fue lanzado por primera vez el 18 de septiembre de 2008, 16 días después de la publicación inicial de Chrome. De acuerdo a los desarrolladores de Iron, El código fuente de Chromium fue ampliamente modificado con el fin de eliminar cualquier seguimiento de la funcionalidad relacionada. El 22 de enero de 2009, fue liberada una versión de desarrollo.
Las versiones más recientes de Iron desde que ha sido liberado, han adquirido las características del código de base subyacente de Chrome, incluyendo soporte para temas, la posibilidad de cambio de agente de usuario, un sistema de extensiones, y soporte mejorado para Linux.
El 7 de enero de 2010 se publicó la primera versión para Mac OS X.
Diferencias con Chrome:
Las siguientes funciones de Google Chrome se han eliminado o desactivado en Iron:
* RLZ identifier: Una cadena codificada enviada junto con todas las consultas a Google o cada 24 horas.
* No tiene como página de inicio por defecto la página de búsqueda de Google, como motor de búsqueda predeterminado
* Un identificador (ID) único ("clientID"
para identificar al usuario en los registros de accesos.
* Una Marca de tiempo (Timestamp) de cuando fue instalado el navegador.
* Páginas de error alojadas en servidores de Google, cuando no se encuentra un servidor.
* Instalación automática de "Google Updater".
* DNS "pre-fetching".
* sugerencias automáticas de búsquedas en la Barra de direcciones.
* Sistema de seguimiento de errores que envía información sobre cuelgues del navegador o errores.
2.
Buscador Google – DuckDuckGo (no es un buscador Open Source, pero al menos no registra tus movimientos)
Google siempre ha sido criticado porque se dice que guarda nuestros datos, desde cuando hacemos una búsqueda, hacemos un clic en algún anuncio, vemos algún video, buscamos alguna dirección, enviamos algún correo electrónico, etc, etc.
Y “agarrándose” de esto, ha salido DuckDuckGo, un buscado web que asegura que ellos no rastrean ni guardan nuestra información. La gente de DuckDuckGo esta enfocada en la privacidad y su publico objetivo son todas las personas que se preocupan a morir por la privacidad de sus datos.
Pero seamos sinceros y démonos cuenta de que la seguridad y protección de nuestra información y nuestros datos depende de nosotros, de nadie mas. Nosotros somos los responsables de cuidar lo que compartimos en la web.
No estoy defiendo a Google, pero si quiero recomendarles que seamos un poco mas conscientes de nuestras propias actividades en Internet, muchos han (hemos) pasado por amargas experiencias que nos han hecho escarmentar.
Yacy
Con el inesperado cierre de Wikia Search, se hace necesario buscar alternativas a los buscadores privativos y monopólicos como Google o MSN Search. Yacy es una de ellas y es quizá la mejor, nos permite navegar anónimamente y sin censura.
¿Por qué? Porque YaCy funciona desde hace bastante tiempo y con la filosofía de las redes P2P, tal como lo hacen los conocidos clientes Emule o Ares para intercambiar archivos, YaCy se encarga de las búsquedas en Internet.
En http://141.52.175.50:8080/ podemos hacer una prueba gracias al Sciencenet @ LiebelLab, pero existen muchas otras computadoras en el mundo corriendo YaCy, compartiendo información y recursos.
Aquí hay una lista completa de todas ellas: http://www.yacyweb.de/peers.htm
Cada máquina que corre Yacy es un “peer”, o “par”, si existieran millones de Yacys instalados podríamos superar con creces la capacidad de procesamiento de Google y así tiraríamos abajo lo que ahora se ve como un gigante todopoderoso.
Hay que tener en cuenta que hace unos años pensábamos que era casi imposible doblegar al Internet Explorer, hoy en día cualquier usuario más o menos informado usa el Software Libre Firefox; hace unos años nadie pensaba que la enciclopedia privativa Encarta moriría en manos de la libre Wikipedia, hoy en día el software libre y su filosofía de colaboración online se encuentran triunfando e incluso representa el puntal de innovación en la industria TI según la consultora Forrester.
Volvamos a Yacy: podemos usar este buscador P2P a diario más fácilmente si lo sumamos como predeterminado en los motores de búsqueda de Firefox u otro navegador libre. En el caso de Firefox desplegaremos la lista y elegiremos “Añadir YaCy Search on (nombre del servicio)”, de tal forma en vez de buscar por Google buscaremos en YaCy y aprenderemos a ver Internet de otra manera.
Probando varios peers, he llegado a la conclusión de que http://yacy.dyndns.org:8000/ es el mejor de todos en materia de velocidad de respuesta, cantidad de contenido almacenado y conexión con otros peers.
Nuestras mentes están tan colonizadas por la visión que tiene Google del mundo que al principio será extraño el sentimiento de usar otro buscador, pero el futuro de la libertad de expresión, de pensamiento y de construcción del conocimiento en Internet dependerán también de ello.
¿Qué es lo que falta? Al menos veo 2 cosas:
* Que muchas otras personas, además se usar YaCy, lo instalen en su PC y así colaboren con recursos de procesamiento.
* Crear un dominio con un nombre corto y fácil de recordar que redireccione hacia el mejor peer o tenga instalado YaCy conectado a todos los peers existentes.
¿Alguien se anima?
Cosas que vale la pena saber al comenzar a usar Yacy
No soy un experto en Yacy. Este texto contiene algunos consejos para que Yacy no consuma tantos recursos en nuestro sistema que he aprendido en la práctica. A continuación explico algunas cosas que tuve que aprender al usar Yacy, el buscador p2p. Por ejemplo, cómo configurar Yacy para que no consuma tantos recursos de RAM y procesador y podamos realizar otras actividades sin apagar el buscador. También explicaré como configurar el proxy con Yacy e indexar páginas mientras navegamos, además de algunos consejos sobre cómo crawling (recolectar?) urls sin “atascar nuestro pc”.
1. Configurar el uso de RAM en Yacy
En los menus de la izquierda debemos hace clic en “Admin Console”, luego en el menú de arriba en “Performance”.La primera casilla dice “Memory Setting” por defecto viene 600 mbs de memoria. Esto es demasiado para PCs con 1GB o menos de RAM. Es recomendable introducir un valor menor (yo probé con 200 mbs), lo cual reducirá el rendimiento de Yacy pero dejará más espacio libre para otros procesos. Luego haces clic en “set” para aplicar el cambio.
2. Configurar el porcentaje que se utiliza para crawling (recolectar?)de la performance definida
En la misma sección de “Perfomance”, más abajo dice “Use Default Profile”. Recomiendo para PCs de escritorio o notebooks seleccionar valores como 25% o 10%. Esto mejora el rendimiento de tu computador mientras usas Yacy. Clic en “Save” para aplicar la configuración (se debe reiniciar Yacy).
3. Configurar las cantidad de páginas que se procesan por minuto
El proceso de crawling (que yo traduciría por recolección) de urls consume muchos recursos del procesador. Para reducir la cantidad de páginas por minuto hacemos clic en “Crawler Monitor” ubicado en el menú izquierdo de Yacy. Uno de los cuadros desplegados dice “Speed”, en aquella sección haz clic en el botón “minimun” para ordenar a Yacy que recolecte solo 10 páginas por minuto. Esto dará un respiro a tu Pc. Puedes aumentar el valor según la potencia de tu Pc o si te dedicas exclusivamente a Yacy.
4. Crawling (recolectar?) urls en forma manual
Para crawling/recolectar urls e indexarlos local y remotamente (hacia otros peers de Yacy) en forma manual conviene hacerlo desde “Crawl Start Expert”. Para ellos hacemos clic en “Index Creation” ubicado en el menú izquierdo, luego en el menú superior buscamos “Crawl Start Expert”. En “Starting Point” se introduce el url inicial, desde donde comenzará nuestra recolección. En Crawling Depth (profundidad) se debe introducir un valor. El valor 0 significa que se recolectará sólo el url de partida. Entre más profundo (más alto el número) más urls del sitio recolectará, lo cual toma más tiempo y más recursos. Elige el valor que más te convenga y según la importancia que le concedes al sitio y a sus páginas interiores. Luego puedes ver otras opciones como “Maximun Pages per Domain”, opción que permite limitar el número de páginas que se recolectan por sitio, y otras opciones que no explicaré aquí. La opción importante de marcar es “Do remote indexing”, la cual permite que lo que recolectas sea indexado en otros peer también. Para iniciar la recolección, haces clic en “Star New Crawl” y comenzará el proceso.
5. Crawling (recolectar?) urls mientras navegas
Para recolectar e indexar urls mientras navegas Yacy ofrece un proxy. Para emplearlo debes configurar tu navegador. Si usas Firefox esto se hace en “Editar” luego en “Preferencias” luego en “Avanzado” luego en la pestaña “Red” luego en “Configuración” y se abrirá la ventana “Configuración de conexión”. En la ventana seleccionas “Configuración manual de proxy”. En la caja que dice “Proxy HTTP” introduces “localhost” y donde dice “Puerto” introduces “8080”. Seleccionas la casilla usar mismo proxy para todo. Para no tener problemas al ingresar a algunas páginas, más abajo donde dice “No usar proxy para” introduces las excepciones separadas por coma. Por ejemplo: gmail.com,gnewbook.org De esta forma no se usará el proxy al ingresar a esas páginas que requieren autenticar. Una ves hecho esto, y si Yacy está encendido, recolectará en indexara las páginas que abras en tu navegador. El proxy funciona por defecto en profundidad 0 por lo que no atascará tu computador. Importante: si Yacy está apagado, no podrás navegar con este proxy.
Espero que estos consejos te hayan servido para usar Yacy sin consumir todos los recursos de tu computador. Saludos.
3.
Gmail y la alternativa de Roundcube.
Si necesitáis ofrecer un cliente de email en vuestra empresa, Roundcube puede ser una buena solución, gratuita y de código abierto.
Entre otras cosas puede configurarse en varios idiomas, soporta HTML, tiene agenda de contactos, dispone de un motor de búsqueda de mensajes, tiene gestión de directorios IMAP, corrector ortográfico y API, con lo que no tiene nada que envidiar a otros clientes de correo más utilizados y no gratuitos.
Funciona con Php y Mysql y podéis ver más capturas en roundcube.net/screens.
Round Cube es otro webmail con licencia GPL y soporte multilenguaje. Además incluye IMAP, soporte para MIME, incorpora libreta de direcciones, permite la manipulación de carpetas, posee búsqueda de mensajes y corrector ortográfico.
Este está escrito en PHP y hace uso de MySQL o Postgres. Su interfase soporta skin y usa XHTML y CSS2.
Llevo algunos años usándolo ya que viene instalado en los servicios de hosting que vendo y la verdad es que funciona muy bien, la interfase es bastante moderna, agradable y funcional. No es que me vuelva loco, pero muchas veces las opciones de webmail que encontramos en los hosting son lamentables y Round Cube brinda un entorno agradable, una experiencia de usuario amena y todas las funcionalidades que se necesitan cuando hay que consultar el correo desde el navegador.
4.
Google Reader y la alternativa de Newsblur.
Todos ya sabemos que Google Reader es quien tiene el liderazgo casi absoluto en el terreno de los lectores de feeds. No hay muchas alternativas, y la mayoría de ellas no le llegan ni a los talones (ni en cantidad de usuarios ni en funcionalidades). Y las pocas que sí lo hacen, como FeedDemon, se sincronizan con el mismo Google Reader, por lo que de todas formas tenemos que pasar por la compañía de la gran G.
Por eso NewsBlur es un lector RSS digno de destacar, ya que está a la altura del producto de Google, y a la vez es totalmente independiente de este (no necesitamos una cuenta Google para usarlo).
Pero, ¿Que ventajas nos ofrece NewsBlur por sobre Google Reader de toda la vida? Principalmente, que posee un sistema de recomendación y filtros muy bien implementado. Se nos da la opción de “votar” cada noticia que leamos, y especificar qué nos gusta/interesa de ella, si es el blog donde fue publicada, el autor que la redactó, o el tag/categoría asociado al post.
De ese modo, si por ejemplo nos gustan los posts de Alkar en Genbeta, o de Joshua Topolsky en Engadget, NewsBlur identificará automáticamente este patrón y empezará a destacar estos posts para que los tengamos más a la mano. Inclusive, el lector detecta las palabras clave, tags, o categorías más comunes entre los posts que nos gustan.
Asimismo, si nos desagradan los post de cierto editor, o si estamos aburridos de los artículos sobre cierto tema podemos especificar que no nos gustan y también se creará un patrón a partir de eso.
¿Y qué ganamos con todo eso? Pues que NewsBlur empezará a clasificar automáticamente los nuevos feeds entre interesantes, normales, y poco interesantes, a partir de los criterios ya entregados. De ese modo, si andamos con poco tiempo, podemos leer solo los feeds seleccionados por NewsBlur, y dejar de lado aquellos que traten sobre temas que no nos interesen.
Pero eso no es todo, ya que hay otras opciones que ya están en Google Reader, pero que NewsBlur las implementa mejor. Por ejemplo, en el lector de Google se puede , pero en NewsBlur se puede elegir la fecha tope de forma más granular. También deja acceder a la página original del post sin salir del lector, y ofrece estadísticas más completas que Google Reader. Además, la interfaz de NewsBlur es tremendamente rápida y atractiva visualmente. Y por si fuera poco, están a punto de lanzar una aplicación para iPhone que se se sincronizará con el lector web-based.
Desgraciadamente, hay unas cuantas cosas que NewsBlur se deja en el tintero y que quizás muchos de ustedes echen de menos. Por ejemplo, no permite leer los feeds agrupados por carpetas (deja ordenarlos en carpetas, pero obliga a leer los feeds de uno en uno).
Para sacarle el jugo a NewsBlur debemos crearnos una cuenta y agregar los feeds, pero esto tampoco es mucho problema, ya que podemos importar toda la configuración de Google Reader con tan solo ingresar con nuestra cuenta de Google.
5.
Google Talk y la alternativa de Ekiga.
Ekiga, anteriormente llamado GnomeMeeting, es una aplicación de software libre para realizar videoconferencias y telefonía IP para GNOME. Usa el hardware o software compatible con H.323 (como Microsoft Netmeeting) y se libera bajo licencia GPL. Además está disponible para sistemas Unix y Windows.
Permite todas las características modernas de una videoconferencia como soporte de proveedor inteligente o llamadas de telefonía desde el ordenador a un teléfono.
Para su correcto funcionamiento debe disponerse de una cuentas SIP, que puede crearse gratuitamente desde [2]. Por otro lado para poder realizar llamadas a teléfonos convencionales desde el PC se debe disponer de una cuenta con algún servidor de telefonía por internet. El mismo programa recomienda el proveedor Diamondcard Worldwide Communication Service, si bien existen muchos otros como VoIPBuster. Estos servicios no son gratuitos sino que se paga al proveedor del servicio en función del teléfono de destino según
sus tarifas.
6.
Google Docs y la alternativa de TeamDrive extensión para OpenOffice (y suponemos que en el futuro para LibreOffice)
7.
Picasa y la alternativa de DigiKam.
DigiKam es un potente gestor fotográfico que viene desde Linux con una batería de herramientas y funcionalidades que harán las delicias tanto de aficionados y profesionales de la fotografía.
Con DigiKam podrás organizar tus imágenes, asignarles etiquetas, editar sus metadatos e ítems de geolocalización, corregir errores o problemas de luz y de color, ver tu colección como una presentación o importar y exportar fotos en Flickr, Piwigo, Picasa, Facebook o SmugMug, entre otros.
El único defecto de DigiKam es su mejorable integración con Windows, que produce en ocasiones problemas para añadir imágenes o abrir carpetas del disco.
Digikam es un gestor de álbumes de foto fresco, sutil y muy completo con sus funciones de edición básica y extensa colección de añadidos gracias al uso del sistema nativo de plug-ins Kipi. Con Digikam podrás importar y organizar tus fotos en álbumes, por fecho pero también mediante la creación de etiquetas.
Hoy en día el uso de etiquetas se está popularizando bastante. Son palabras claves que se asignan a cada imagen para describirla, unas etiquetas que aprovecharemos para navegar de forma más ingeniosa por nuestra librería, algo muy similar al servicio de álbumes online Flickr.
Digikam permite crear álbumes de fotos y organizarlos cronológicamente, pero también usar el modo de edición para retocar nuestras imágenes con gran facilidad. Con Digikam podrás añadir comentarios y disfrutar de añadidos muy variados gracias al subsistema Kipi, como por ejemplo la función de ojos rojos, filtros de imágenes o efectos especiales.
Página de Iron:
www.srware.net/en/software_srware_iron.php
Página de DuckDuckGo:
http://duckduckgo.com
Página de Newblur:
http://www.newsblur.com/
Página de Roundcube:
http://www.roundcube.net/
Fuentes:
http://www.muylinux.com/2011/02/17/alternativas-open-source-a-los-servicios-de-google/
http://es.wikipedia.org/wiki/Ekiga
http://es.wikipedia.org/wiki/SRWare_Iron
http://miguelalejoescritor.wordpress.com/2010/11/08/configurar-yacy-para-un-buen-desempeno/
http://www.genbeta.com/web/newsblur-una-excelente-alternativa-a-google-reader-que-filtra-los-posts-mas-relevantes
http://www.tendenciadigital.com.ar/index.php/linux/linux-novedades/digikam-1.8.0-organiza-visualiza-y-edita-tus-fotos-en-kde.html
http://www.idiomalibre.com/internet/yacy-buscador-software.php
http://wwwhatsnew.com/2010/02/26/roundcube-un-webmail-para-instalar-en-tu-servidor/
http://zonalinux.com.ar/round-cube-cliente-webmail-muy-completo-y-con-licencia-gpl/
http://www.esmeraldasonline.com/duckduckgo-vs-google-privacidad.html