Ya vimos los métodos para saber que bloques están en cache, ahora tenemos que ver como decidir que bloques nos conviene que estén en la cache. Por ejemplo imaginemos que tenemos una correspondencia directa, en determinada linea X de la cache tenemos un bloque de memoria al que el procesador uso recientemente, ahora el procesador requiere otro bloque de memoria que le corresponde la linea X de la cache, a la lógica de la cache no le queda otra que sacar el bloque actual y poner el nuevo. Pero con las otras 2 correspondencias la lógica de la cache tiene varios lugares para poner ese bloque que el procesador requiere. En esta parte vamos a ver los algoritmos usados para decidir que linea sacar de la cache para alojar el nuevo bloque requerido.
Probablemente el mas efectivo el LRU (Last Resently Used) "utilizado menos recientemente". En este algoritmo se reemplaza el bloque que se ha mantenido mas tiempo en la cache sin haberse referenciado. Esto es fácil de implementar en la correspondencia asociativa por conjuntos de dos vías, solo necesitamos 1 bit extra por linea, cuando una linea es referenciada se pone ese bit extra de esa linea en 1, y el de la otra vía en 0. Cuando necesitamos guardar un nuevo bloque, es tan simple como elegir la linea que posea el bit extra en 0.
Otra posibilidad es el FIFO (FIrst In First Out) "primero en entrar, primero en salir" En este algoritmo se reemplaza el bloque que ha estado mas tiempo en la cache, esto es implementado fácilmente mediante una técnica cíclica "buffer circular".
Otra podría ser LFU (Last Frequently Used) "menos frecuentemente usado", en este caso se sustituye la linea que posee menos referencias hechas, para esto se tendría que implementar un contador.
Otra técnica no basada en el grado de utilización seria en elegir la linea aleatoriamente (al azar). Estudios realizados indican que las prestaciones de esta técnica son levemente inferiores a las descriptas anteriormente basadas en el grado de utilización.
Política de escritura:
Un problema que todavía no se ha mencionado es el tema de la validez de los datos un bloque de memoria principal respecto a la linea correspondiente en cache.
Imaginemos una linea de cache la cual a sido modificada por el procesador, ahora el procesador requiere un bloque de memoria el cual va a ser alojado en esa linea modificada de la cache. La lógica de la cache debe actualizar el bloque de memoria principal correspondiente a la linea modificada antes de alojar el nuevo bloque.
Bien con el problema ya descripto, vamos a explicar algunas técnicas de escrituras que difieren en su prestación y costo de implementación.
Existen 2 grandes problemas a resolver. Primero, mas de un dispositivo puede tener acceso a la memoria principal, por ejemplo imaginemos un modulo de E/S que accede para lectura a la memoria principal, si la dirección accedida esta en cache y fue modificada, el dato que se lleva el modulo de E/S va a ser erróneo. Ahora imaginemos que el modulo de E/S va a realizar una escritura, y la dirección en cuestión esta en cache y fue modificada, cual es el dato valido?, el de la cache o el del modulo de E/S?.
Una vez que una dirección se ha modificado en la cache, la dirección correspondiente de memoria deja de tener validez.
Otro problema mas complejo se da en sistemas con varios procesadores en que cada uno posee su propia cache. El hecho de modificar una dirección de la cache, no solo invalida la dirección correspondiente en la memoria principal, sino que también podría invalidad datos de las otras caches.
La técnica mas sencilla es la llamada "escritura inmediata", todas las escrituras se hacen tanto en cache como en memoria principal. Para los sistemas con varias unidades procesador-cache, estos pueden monitorizar el trafico hacia memoria y detectar modificaciones en direcciones que dichas caches contienen, para así mantener la coherencia de datos. La principal desventaja de esta técnica es que aumenta considerablemente el trafico a través del bus, hacia la memoria principal, lo cual podría producir un cuello de botella en el sistema.
Otra técnica es la llamada "post-escritura", el la cual se minimizan las escrituras en memoria. En esta técnica la cache dispone de un bit extra por linea de cache, en el momento de modificar un bloque, esta modificación solo se hace en la cache, además de modificar el bloque, se utiliza ese bit extra para marcar que el bloque ha sido modificado. Recién en el momento de sustituir el bloque de la cache, se chequea este bit extra para saber si se ha modificado el contenido, si se ha modificado, antes de reemplazar el bloque se actualiza la memoria principal.
Como una parte de los datos de memoria no son validos porque todavía no se han actualizado, los accesos de los módulos de E/S deben hacerse a través de la cache para chequear primero si están ahí, y entonces usar información valida. Esto hace que la circuitería tenga que ser mas compleja, y existe la posibilidad de que se genere un cuello de botella.
En sistemas con mas de una unidad procesador-cache, no solo alcanza con mantener la coherencia entre la cache modificada y la memoria principal, sino que además hay que mantener la coherencia entre la información de las cache, a un sistema que tiene en cuenta este punto se le dice que mantiene la coherencia de cache.Entre las técnicas usadas pala lograr esto se encuentran:
Vigilancia del bus con escritura inmediata:
Todas las caches monitorean las lineas de direcciones del bus, cuando una cache detecta que se ha modificado un bloque de memoria que ella posee, procede a invalidar su linea de cache.
Transparencia hardware:
Se utiliza hardware adicional, cada ves que una cache es modificada, este hardware se encarga de mantener la coherencia con la memoria principal y otras caches.
Memoria excluida de cache:
Con esta técnica solo una porción de la memoria principal es compartida por los procesadores, esta memoria no es transferible a la cache, por lo cual cada vez que se accede a la memoria compartida por parte de un procesador, quiere decir que antes se ha producido un fallo en la cache, porque es imposible que que la memoria compartida se encuentre en cache
Tamaño de linea:
Cuando el procesador requiere acceder a una palabra de la memoria principal, el sistema lleva a la cache no solo esa palabra sino también las palabras de su vecindad, lo que se llama bloque, para aprovechar el principio de localidad. Bien, ahora, cual sera la cantidad óptima de palabras que deba contener ese bloque?. Al ir aumentando la capacidad de palabras de la linea de cache va a ir aumentando la tasa de aciertos, por el hecho de tener mas palabras próximas a la referenciada, con posibilidad de ser usadas, pero al pasar un cierto numero de palabras, la proximidad se va haciendo mas lejana, y así empieza a reducirse la tasa de aciertos, en ese punto seria mas conveniente reemplazar la linea.
Dos factores entran en juego en este tema:
Primero es que cuanto mas grande sean los bloque menor sera el numero de estos que entren en la cache. Y el hecho de que halla menos bloques, produce que este permanezca menos tiempo en cache, por sera reemplazado por otro mas rápidamente, no pudiéndose aprovechar completamente el principio de localidad.
Segundo, es que cuando mas palabras tenga el bloque, mas lejana va ha ser la proximidad de las palabras extra con respecto a la requerida en consecuencia menos probable va a ser que sea requerida en corto plazo.
Es difícil establecer un numero de palabras óptimo, por haber muchas variables en juego, pero parecería que un tamaño entre 4 y 8 unidades direccionables seria próximo a lo óptimo.
Numero de caches:
Debido al aumento logrado en la integración de los circuitos, se ha logrado reducir considerablemente los tamaños de las caches, lo que permitió incorporarlas dentro del mismo procesador, reduciendo los tiempos de acceso hasta hacerlos casi nulos.
Luego se incorporo un segundo nivel de cache, mejorando aun mas los tiempos promedio de acceso a datos e instrucciones alojados en memoria principal.
Además de incorporar 2 niveles de cache, se ha hecho normal particionar la cache y dedicar una a almacenar datos y otra a almacenar instrucciones.
Las caches unificadas presentas 2 grandes ventajas, la primera es el tema del balanceo según las necesidades, por ejemplo supongamos el caso ficticio que el procesador requiera de memoria principal solo instrucciones, nada de datos, en el caso de cache partida, una dedicada a datos y otra a instrucciones, tendríamos la cache de datos casi sin uso, en cambio, si no estuviera particionada, el solo uso de la cache balancea según las necesidades la cantidad de instrucciones o datos cargados en la cache. La otra ventaja mas obvia es que solo habría que diseñar e implementar una sola cache.
Pese a esto la tendencia se fue incrementando para el lado de las caches partidas, esto se debe principalmente para explotar mas la técnica de ejecución de tareas en paralelo. En procesadores que se implementa segmentación de cause "Pipelining" , dentro del procesador se realizan en paralelo distintas tareas, y se pueden llegar a requerir en un mismo momento datos e instrucciones. Con la cache partida se elimina la competencia por el acceso a ella, por ejemplo el pre-captador de instrucciones podría tratar de acceder a la cache en busca de futuras instrucciones, y no podría hacerlo, porque la ALU en ese momento esta haciendo uso ella para obtener operandos.
Registros:
Primero recordemos las cosas que debe poder hacer la CPU:
* Captar instrucciones: La CPU lee una instrucción de memoria.
* Interpretar una instrucción: La instrucción debe ser decodificada, para saber que acciones se deben realizar.
* Procesar datos: La ejecución de una instrucción puede requerir que se realice alguna operación aritmética o lógica.
* Escribir datos: La instrucción puede requiere que se escriban datos en memoria o en algún modulo de E/S.
Para realizar estas tareas, la CPU requiere de la capacidad de poder almacenar algunos datos temporales, para eso necesita de una pequeña memoria interna, la cual ya hemos nombrado, que son los registro
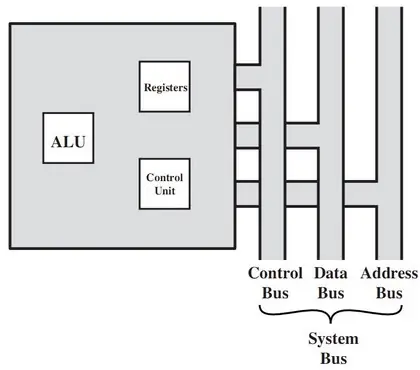
Estos registros están el lo mas alto de la jerarquía de memoria, por lo cual son a los que se accede mas rápidamente, las mas pequeñas, y las mas caras.
Se las dividen en 2 grupos:
Registros visibles al usuario: Permiten a los programadores de bajo nivel, hacer uso de ellas.
Registros de control y estado: Son usados por la unidad de control para controlar la CPU, y son también usados por programas privilegiados del sistema operativo, para controlar la ejecución de programas.
Registros visibles al usuario:
Estos registros pueden ser referenciados por medio de lenguaje de maquina, y podemos clasificarlos de la siguiente forma:
* De uso general.
* Datos.
* Direcciones.
* Código de condición.
Un registro de uso general se puede usar para cualquier cosa, este uso esta estrechamente ligado al repertorio de instrucciones. Por ejemplo hay instrucciones que permiten direccionar una posición de memoria usando cualquier registro, mientras hay otras instrucciones que trabajan con registros específicos. La ventaja de un registro de uso general, es la flexibilidad en el trabajo que le da al programador, la desventaja de un registro general y a su ves ventaja de un uso especifico (datos o direcciones) esta en que las instrucciones no debe especificar en que registro se encuentra el dato o dirección, el registro ya esta implícito con la instrucción, ya se sabe que para determinada instrucción, hay que usar determinado registro, lo que hace a la instrucción mas corta.
También existen instrucciones de direccionamiento que hacen uso de un registro determinado, pero ese registro además se le puede dar otro uso, seria de uso mas o menos general.
Un tema importante a tener en cuenta es la cantidad de registros de uso general, esta cantidad afectara a la longitud de las instrucciones, ya que mas registros requieren mas bits para poder identificarlos, por lo cual en las instrucciones necesitaran mas bits en el campo del operando.
También debemos tener en cuenta el tamaño del registro, Los de direcciones deben poder contener la dirección mas alta, los de datos deben poder contener los valores de los distintos tipos de datos. En algunos sistemas se permite el uso de dos registros como si fuera uno solo para aumentar su capacidad.
La ultima clasificación de los registros visibles al usuario son los que almacenan los códigos de condición o "Flags". Estos flags son bits, que utiliza el hardware de la CPU para indicar algún tipo de información adicional al resultado de la operación que acaba de realizar, por ejemplo, si realizo una operación aritmética, los flags nos van a indicar, si hubo carry, overflow, si fue positivo, negativo, nulo, la paridad, etc. Son de mucho uso para corroborar resultados. Muchas veces también se realizan operaciones y solo se miran los flas, por ejemplo en operaciones de salto o bucles, se toma la decisión de saltar o volver a ejecutar el bucle luego de hacer una comparación "=", en la ALU realizaríamos una resta de los 2 operandos y solo habría que chequear el flag que nos indica si el resultado fue cero. O por ejemplo si la comparación que hiciéramos fuera un "A<B" , en la ALU haríamos A-B y solo habría que chequear el flag que nos indica si el resultado fue negativa, en si el resultado no nos interesa.
Estos registros son visibles al programador o parcialmente visibles, pero no se pueden modificar. Hay ciertas instrucciones como las de llamada a subrutina, que hacen una copia de estos registros, luego durante la ejecución de la subrutina la CPU hace uso de estos registros, y cuando se retorna al programa que llamo a la subrutina, se vuelven a poner los mismos valores en estos registros para asi poder continuar con la ejecución tal cual como lo venia haciendo antes de la llamada a subrutina.
En otras máquinas, cuando se llama a la subrutina, el resguardo de los flags no se hace automáticamente por la CPU, en esos casos es responsabilidad del programador.
Registros de control y estado:
Estos registros se usan para controlar el funcionamiento de la CPU, en general no son visibles al usuario, y , algunas de ellas pueden ser visibles por instrucciones de máquina ejecutadas en modo de control o de sistema operativo.
Los mas importantes son:
* PC - Contador del programa (Program counter): Contiene la dirección de la próxima instrucción a captar.
* IR - Registro de instrucción (Instruction register) Contiene la ultima instrucción captada.
* MAR - Registro de dirección de memoria (Memory address register) Contiene la dirección de una posición de memoria.
* MBR - Registro intermedio de memoria (Memory buffer register) Contiene la palabra de datos a escribir, o la que se a leído ultima.
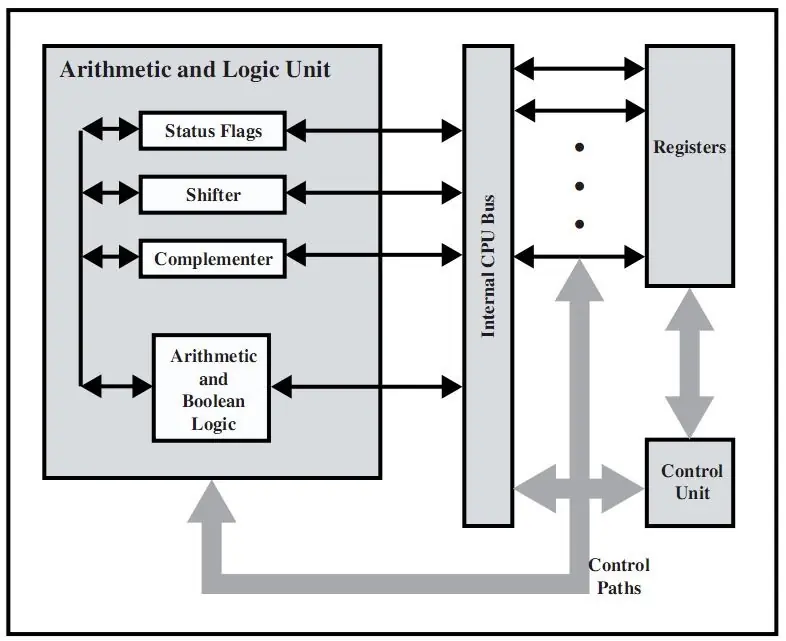
En este gráfico podemos apreciar un poco mas en detalle la estructura interna de la CPU, se pueden ver las conexiones internas, un bus interno, las conexiones de datos de los registros, y las conexiones de la unidad de control para indicarle al los registros, que operación queremos realizar (lectura o escritura) también se pueden ver los flags.
Procesador:
Ciclos de una instrucción:
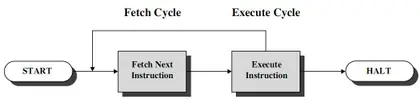
Como ya hemos visto la función de un computador es la ejecución de un programa, el cual esta compuesto por un conjunto de instrucciones, y es el procesador el que se tiene que encargar de ejecutarlas. Dicha ejecución la voy a empezar a describir empezando por la forma mas simple, en 2 etapas, captación de la instrucción y ejecución de la instrucción, entonces la ejecución de un programa consta en la repetición del proceso de captación y ejecución de instrucciones.
Básicamente se capta la instrucción de memoria principal, se guarda el código de la instrucción en el registro IR,se incrementa el registro PC, la CPU interpreta la instrucción almacenada en IR y realiza las acciones necesarias para que se ejecute la acción requerida.
IAC - Instruction address calculation: En general consiste en sumar 1 al registro PC, pero no siempre. Supongamos que las instrucciones tienen un largo de 16 bits y la memoria esta direccionada de a 16 bits, en ese caso sumariamos 1 al PC, pero si la memoria estuviera direccionada de byte, cada instrucción ocuparía 2 posiciones de memoria, en ese caso tendríamos que sumar 2 al PC.
IF - Instruction fetch: La CPU lee la instrucción desde su posición en la memoria.
IOD - Instruccion operation decoding: Decodifica la instrucción para saber el tipo de operación a realizar y los operandos a utilizar.
OAC - Operand address calculation: Si el o los operandos se encuentran en memoria o se accede a ellos a través de E/S, se determina la dirección.
OF - Operand fetch: Se capta el operando de memoria o a través de E/S.
DO - Data operation: Se realiza la operación que requiere la instrucción.
OS - Operand store: Se almacena el operando en memoria o a través de E/S.
En el gráfico podes observar varias cosas, las etapas están dispuestas tal que en la parte de arriba están las etapas que requieren salir del procesador, y la la parte inferior están las etapas que se solucionan internamente.
Otra cosa para destacar son las flechas dobles en el momento de ir a buscar un operando o al almacenarlo, esto se debe porque hay instrucciones que requieren varios operandos y hay otras que generan mas de un resultado.
Por ultimo hay instrucciones que realizan una misma operación con distintos valores de un vector, por eso, al terminar de almacenar el resultado no captan la siguiente instrucción, en vez de eso, captan el próximo valor del vector realiza lo mismo con otros valores.
Interrupciones:
Para seguir con el ciclo de la instrucción voy a dar una idea de lo que es una interrupción, mas adelante la veremos con mas profundidad.
Una interrupción es un mecanismo, con el cual un modulo de E/S puede interrumpir el procesamiento normal de la CPU.
Esto sirve para mejorar el rendimiento del sistema. Este mecanismo puede llegar deshabilitarse si es necesario.
Ejemplo, ya sabemos que la mayoría de los dispositivos externos son las lentos que la CPU, imaginemos la CPU imprimiendo un documento
Procesador a 200 MHz (tiempo ciclo reloj = 5 ns; Ciclos por instrucción CPI = 2 , en promedio)
• Una instrucción tarda en promedio 2 x 5 ns = 10 ns =>lla computadora puede ejecutar ~100 Mips
Queremos imprimir un archivo de 10 Kbytes en una impresora láser de 20 páginas por minuto
• 1 página ? 3.000 caracteres (1 carácter = 1 byte)
• La impresora imprime 60.000 caracteres por minuto = 1 Kbyte/s
Hasta hora lo único que podíamos hacer era que la CPU envíe los datos que pudiera recibir la impresora y esperar que termine de imprimir o que solicite mas datos.
Sin interrupciones:
• La CPU entra en un bucle y envía un nuevo byte cada vez que la impresora está preparada para recibirlo.
• La impresora tarda 10 seg en imprimir 10 Kbytes
• La CPU está ocupada con la operación de E/S durante 10 seg.
(en ese tiempo la CPU podría haber ejecutado 1000 millones de instrucciones)
Con el uso de interrupciones la CPU no tiene que esperar, mandaría los datos a la impresora y seguiría haciendo alguna tarea productiva.
Con interrupciones:
La impresora genera una interrupción cada vez que está preparada para recibir un nuevo byte.
• Si la gestión de interrupción (ATI) tiene 10 instrucciones (salvar contexto, comprobar estado, transferir byte, restaurar contexto, rti)
• Para transferir 10 Kbytes tenemos que ejecutar 10.000 veces la ATI
? ejecutar 100.000 instrucciones para atender al periférico ? la CPU tarda 0,001 seg.
• La CPU está ocupada con la operación de E/S durante 0,001 seg.
• La E/S por interrupciones reduce en 10.000 veces el tiempo que la CPU está ocupada gestionando la impresora.
Esta diferencia es tan marcada porque el periférico es realmente muy lento, con periféricos rápidos, solo con las interrupciones no alcanza para solucionar el problema.
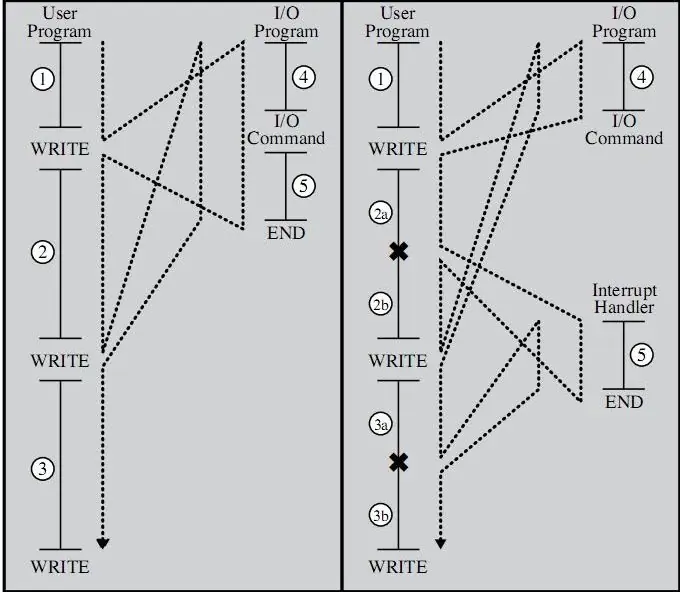
En este gráfico se muestra el tiempo que utiliza la CPU en el periférico, la linea punteada nos marca en que se estaría utilizando el CPU.
Cuando se atiende, un periférico el procesador ejecuta un programa que atiende al modulo de entrada salida, este programa se carga, prepara lo necesario para que se pueda realizar la operación requerida con el periférico, seguido a esto se ejecuta la instrucción solicitada, cuando termina el periférico su tarea, en algunos casos el programa cargado puede realizar alguna otra tarea relacionada, para el lado del periférico o para el lado de los buses, por ejemplo mandar información de algún error que se halla detectado en el periférico, para luego proseguir con la ejecución del programa original.
Se puede ver, en la primera sección, que mientras esta funcionando el periférico (entre los círculos 4 y 5) el CPU no hace nada, solo espera que termine, en cambio se puede apreciar en la segunda seccione del gráfico, que luego de que el programa que atiende la E/S pone en funcionamiento el periférico, el procesador dedica su tiempo en procesar el programa original hasta que reciba una nueva interrupción, las 2 cruces identifican las interrupciones.
Bien, que sucedería si ocurre una interrupción mientras se esta ejecutando una interrupción?
Hay 2 alternativas, la primera es que mientras se esta atendiendo una interrupción se desactivan las demás, luego que se termina de atender la interrupción el procesador, antes de proseguir con la ejecución del programa principal, chequea si hay alguna interrupción pendiente, y así las va ejecutando secuencialmente.
La desventaja es que no se tiene en cuenta ninguna prioridad, y es necesario porque hay peticiones que en la que es importante atenderlas rápidamente y hay otras que no.
La otra alternativa es que las interrupciones tengan prioridad, entonces, si una interrupción es interrumpida por otra que posee mayor prioridad, se almacena el contexto de ejecución de la interrupción en curso, se carga el PC con la nueva dirección y se empieza a ejecutar las instrucciones del programa que atiende la nueva interrupción, al terminar se continua atendiendo la interrupción anterior, y cuando se termina de atender esta, se vuelve a la ejecución del programa principal.