
Grafana es un proyecto que le resultará interesante a aquellas personas que estén desarrollando un sistema de monitoreo en tiempo real. Este recurso consiste principalmente en una interface completamente funcional para el muestreo de gráficas.
El sistema se desarrollo de tal manera que agregar, editar o quitar funciones sea una tarea sencilla, esto se debe principalmente a su diseño estilo modular. Otro aspecto a destacar es su sistema de plantillas, el mismo permite reeditar las secciones con apenas unas pocas lineas, reutilizando el código de manera muy simple.
Desde el punto de vista de la interface, la misma cuenta con varios detalles interesante como por ejemplo la posibilidad de arrastrar y soltar gráficas, reordenarlas, zoom en gráficas, etc.
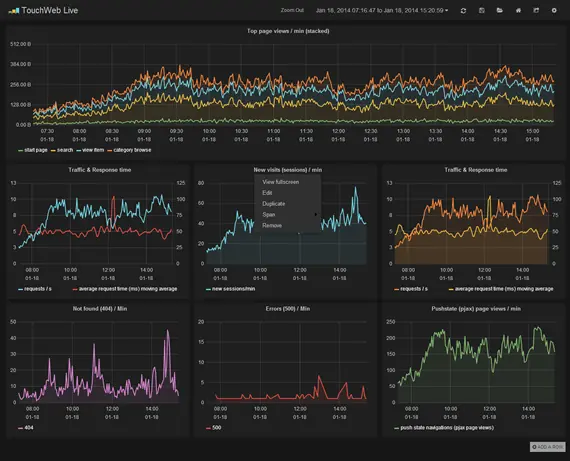
Grafana cuenta con un buen repertorio en cuento a los tipos de gráficas disponibles: barras, lineas, puntos,etc. Además los ejes se pueden personalizar según sea necesario. Algo que me pareció distinto a otras alternativas similares es su posibilidad de cambiar las vistas a modo pantalla completa, algo muy positivo si tenemos en cuenta la cantidad de usuarios que emplean esta función para visualizar en detalle gráficas complejas.
La biblioteca utilizada para mostrar los gráficos es Flot, tiene un repertorio excelente en cuanto a cantidad y calidad de gráficas.
La manipulación de datos que permite este proyecto es otro aspecto a destacar, las gráficas pueden ser exportadas o importadas en formato JSON.
Al tratarse de una interface que emplea JavaScript el lenguaje del servidor es indistinto, solo es cuestión de vincular las gráficas con nuestro servidor para que la interface haga su trabajo, obviamente hay plataformas que son más sencillas de vincular, por ejemplo Node.js tiene grandes ventajas para este tipo de aplicaciones.
Este recurso se encuentra en una etapa de desarrollo inicial, el proyecto tiene cerca de un mes, sin embargo las personas involucradas en él tienen grandes planes para avanzar en cuanto a rendimiento y funcionalidad, por ejemplo esta planeado mejorar la función de arrastrar y soltar, además de mejorar la documentación que es uno de los puntos más flacos de esta iniciativa.
Enlace a esta maravillosa herramienta.
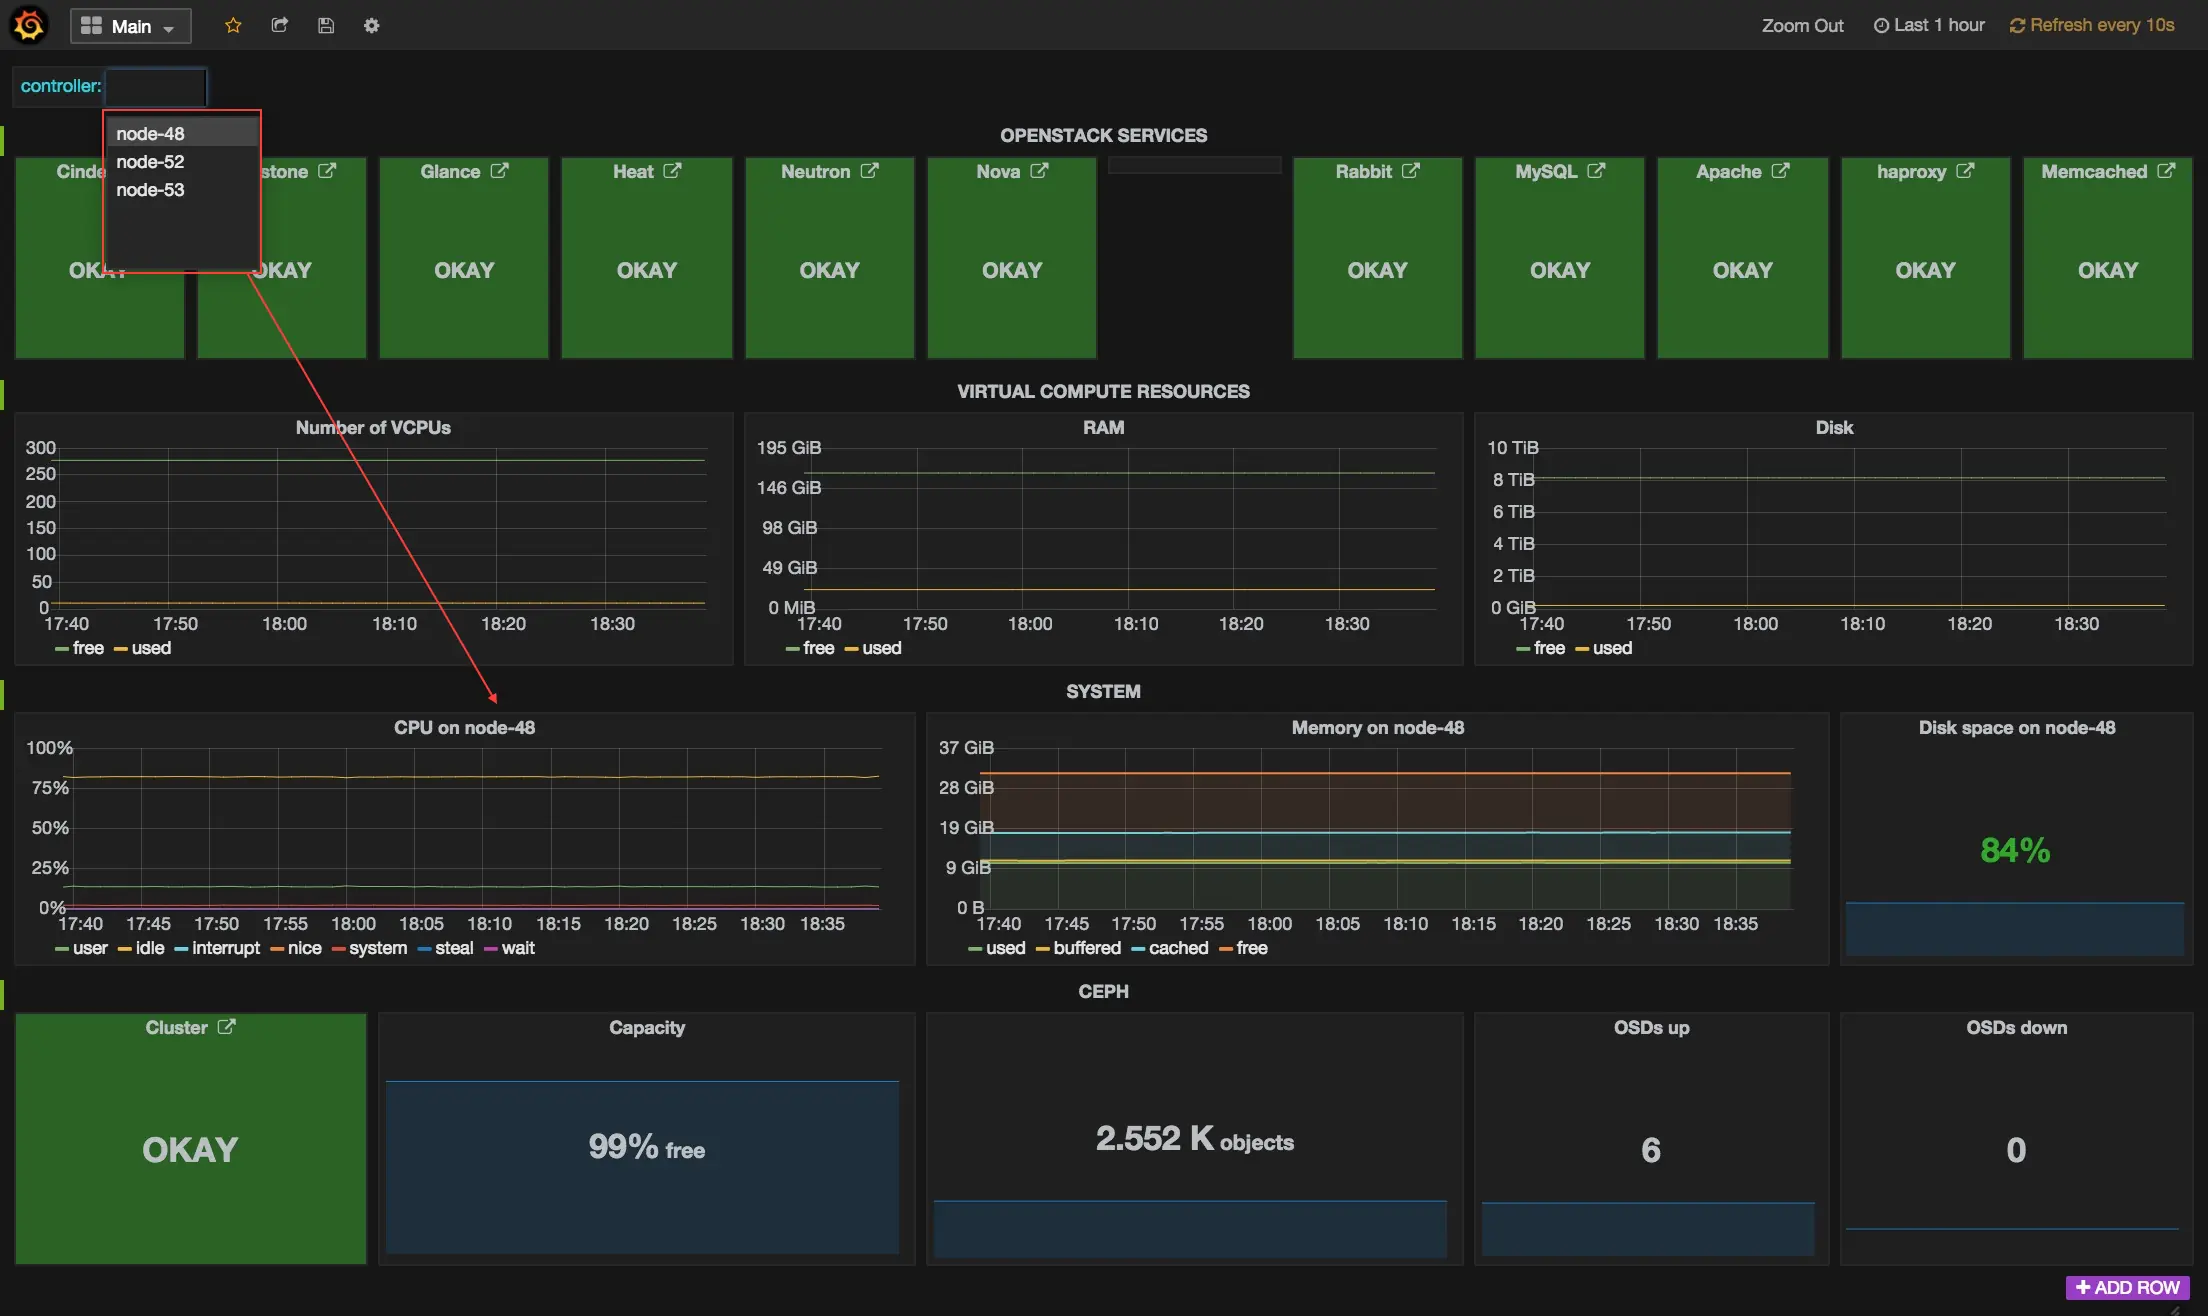
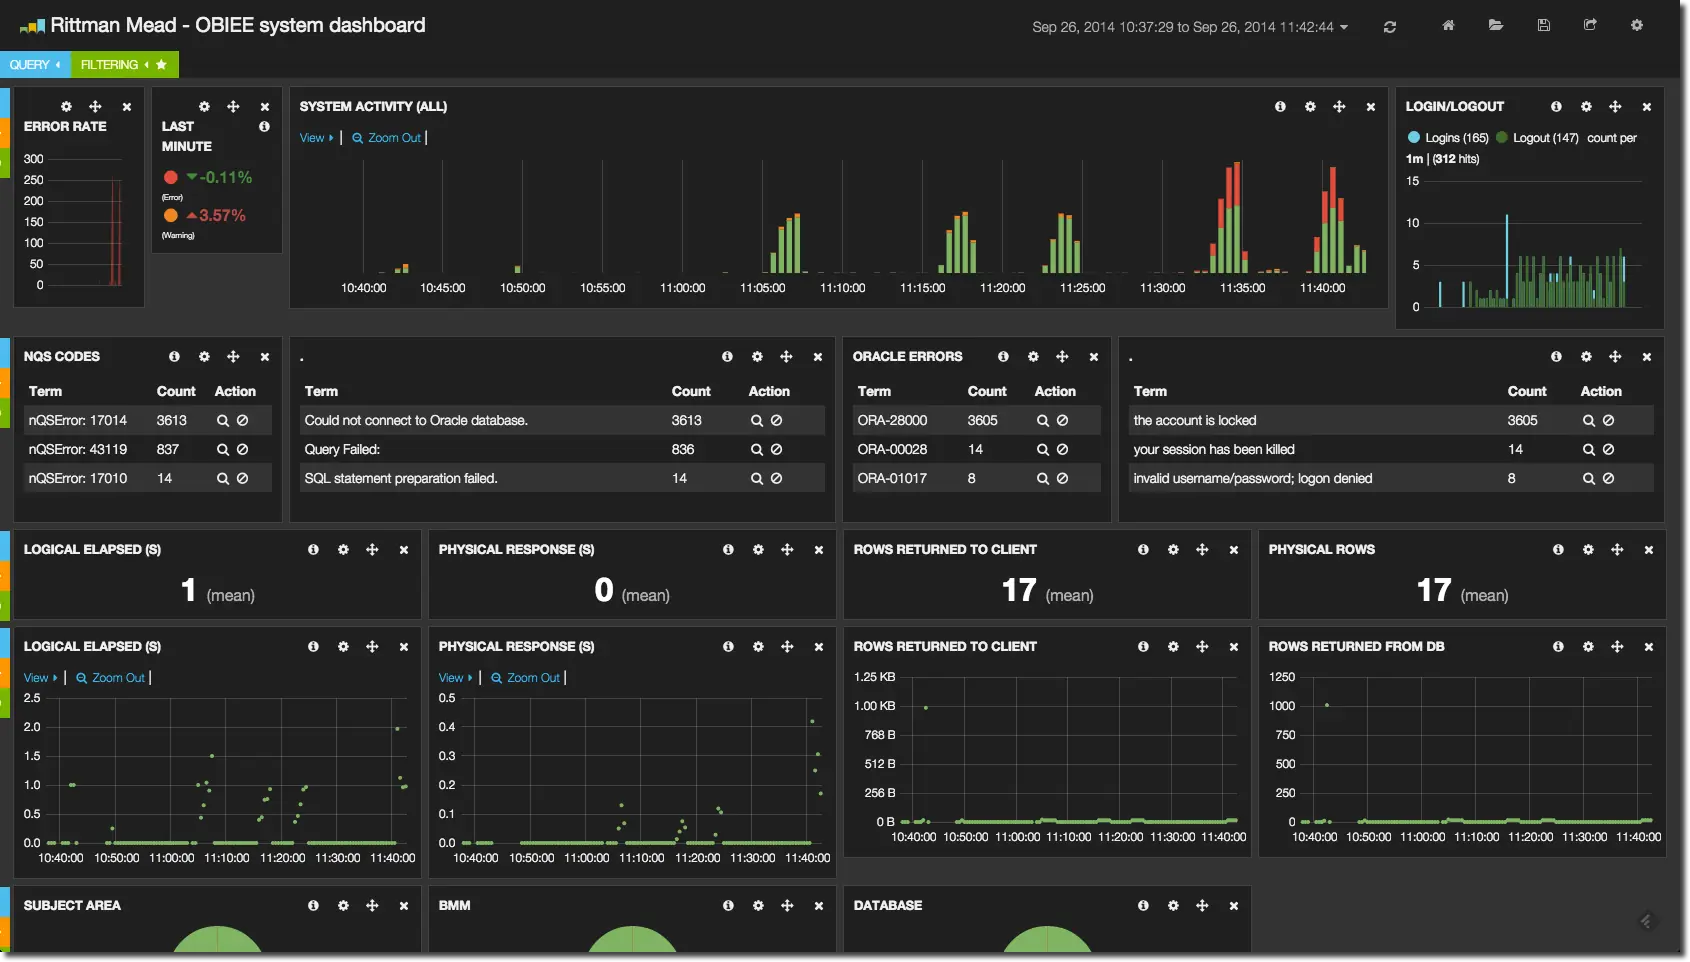
En el trabajo lo utilizo bastante para monitorear los servidores y en caso que este caído recuperarlo rápidamente y evitar perder datos ya que es lo mas importante.
Lo interesante también es que podes utilizar script con python y una base de datos Influxdb para poder en base al script sacar info de la base de datos si la tenes en mysql y luego pasarlo a influxdb para luego utilizarlo con grafana.
Yo principalmente lo uso para ver si esta replicando correctamente.
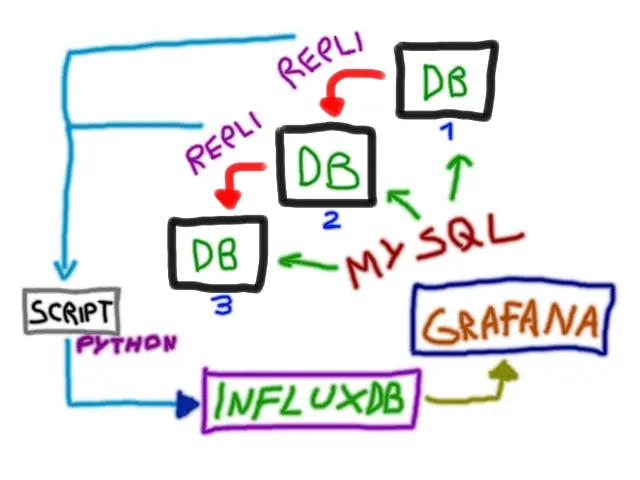
En la imagen se ve como hace el recorrido la informacion hasta llegar al grafana.
Empieza las bd en mysql replica en cada servidor uso un script para recopilar la informacion que necesito sobre la replicacion y la latencia y luego lo guardo en una base de datos llamada influxdb.
De ahi la información la cargo en el grafana.
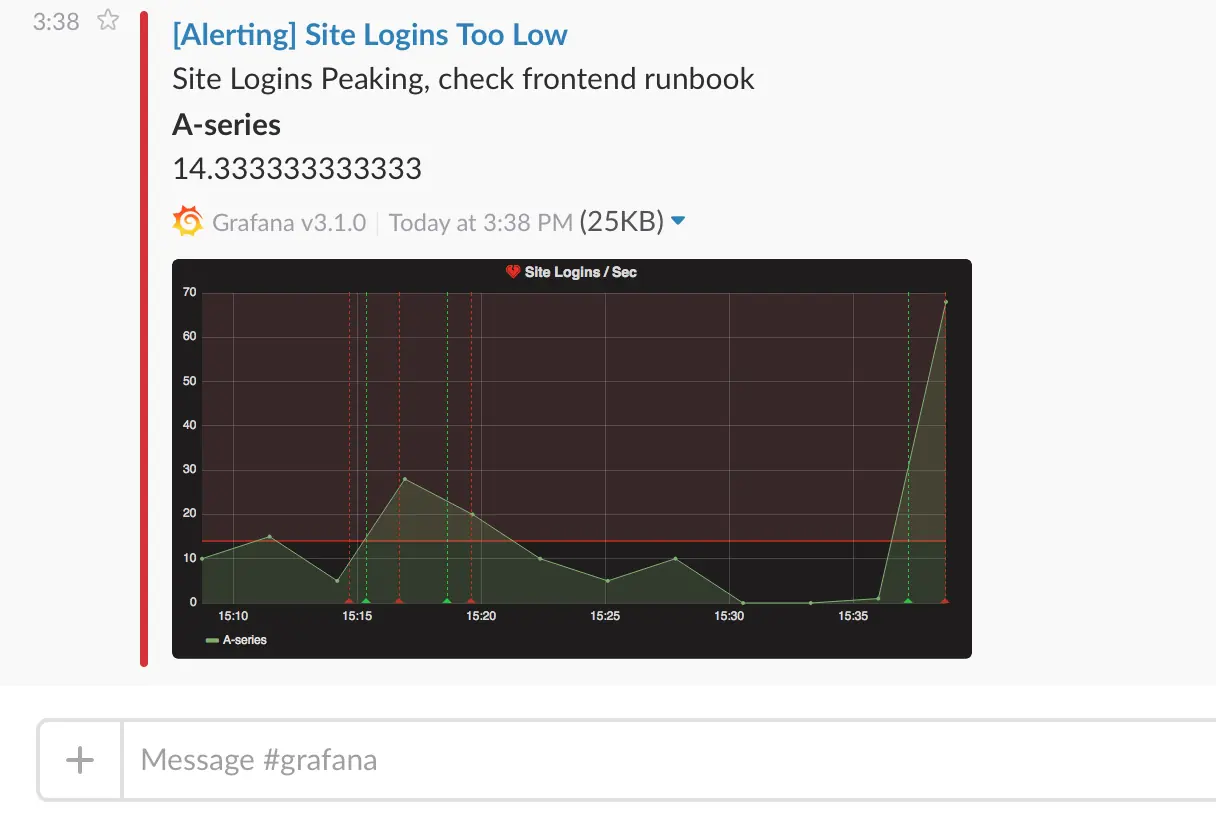
Lo mas interesante de grafana es que podes hacer alertas y que te envié email para notificar cuando algo no se encuentra en buen estado.
Explicación sobre InfluxDB
InfluxDB es una nueva propuesta dentro del mundo de las bases de datos. Escrita en Go, lenguaje de programación inspirado en la sintaxis de C y desarrollado por Google, InfluxDB es un proyecto open source especialmente pensado para desarrolladores que buscan un sistema de almacenamiento para sus aplicaciones que operen en tiempo real.
InfluxDB es una propuesta fresca y completamente nueva, no utiliza ni una sola dependencia adicional para correr. El autor de este proyecto desarrolló este recurso al no encontrar una solución realmente eficiente a la hora de trabajar con métricas, eventos y demás tipos de datos que aparecen al diseñar una aplicación que se ejecute en tiempo real.
Explicación sobre la replicación
El proceso de replicación de una base de datos consiste en replicar las consultas de actualización (tanto DML como DDL) en una base de datos maestra (master) sobre una o varias bases de datos esclavas (slave), de manera que tengamos una copia de las mismas a lo largo del tiempo.
MySQL soporta replicación unidireccional asíncrona, es decir, las consultas de actualización ejecutadas en el maestro son replicadas en los servidores esclavos. Esta replicación se realiza de forma transparente. Además es instantánea si los servidores esclavos están levantandos y en estado de replicación.
Mas información sobre replicación.
