Este es un post que busca desmentir las mentiras y verdades a medias que han estado circulando últimamente por internet. Incluyendo a los medios de comunicación, a quienes confunden Deep Web con TOR, a quienes repiten lo que escuchan sin saber cual es la verdad del asunto.
Lo principal es comprender que si bien TOR, Freenet, I2P, y demás redes anónimas forman parte de la Deep Web, no son el contenido total de la Deep Web. De hecho para ingresar a gran parte del contenido en la internet profunda ni siquiera se necesita de software especializado.
La Deep Web se trata sólo de información no indexada por los motores de búsqueda convencionales. Lo cual significa que normalmente no indexará sitios protegidos por "Robots.txt" ( https://goo.gl/5j33zO ). Así como también las "Redes de entrega de contenido" (CDN, por sus siglas en inglés). En resumen, los buscadores no indexan Links ocultos, o webs de acceso dinámico. Dicho en palabras simples: "Sólo se puede acceder a ellos al cumplirse ciertas reglas".
Veamos un ejemplo. Para evitar hackers una web puede utiliza un cdn. Especialmente si se trata de una web comercial. Entonces, por ejemplo, si abrimos una imagen con un link de la página (Abrir imagen en...), podremos verla, pero si copiamos el link de esa misma imagen e intentamos abrirla en otra pestaña, nos saldrá un cartel de error. Esto sucede porque sólo se puede acceder a esas imágenes si las mismas son abiertas desde la web principal. Si no se cumple este requerimiento, simplemente no se puede ingresar aunque el link esté correcto. Este mismo motivo evita que los contenidos cdn de ciertas páginas web no sean indexadas por los buscadores, ya sean imágenes, libros, audios, y cualquier otro tipo de archivos. Este truco suele usarse mucho en webs de venta. Lo que es lógico, ya que si una página que vende software, te permitiera ingresar al sitio de descarga del software pago desde Google, es probable que muchos no paguen por el servicio. Sin mencionar que todos tendríamos Software legal, versión Pro, absolutamente gratis. Además de tener gratis también los supuestos manuales que te venden sobre como estirarte el amigo (Si eres hombre), o como masajearte los pechos para que se te crezcan (Si eres mujer). Sí, esos manueles existen, y están a la venta, pueden buscarlo si no me creen.
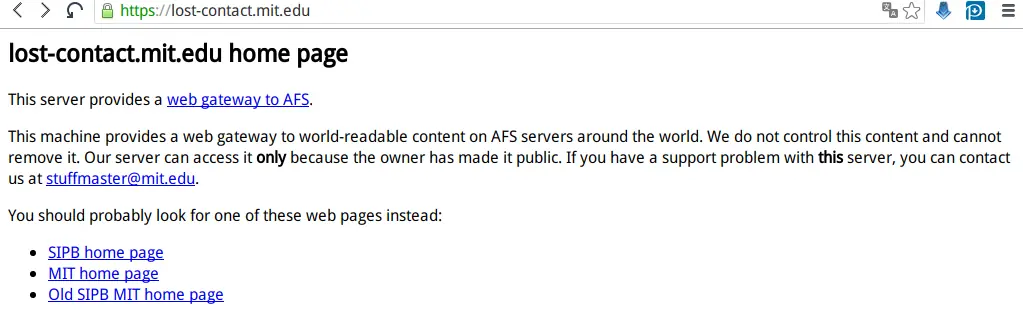
En el año 2014 se estimó que el tamaño de la Deep Web era de 90k TB. Gran parte de su contenido proviene de Universidades. Por ejemplo, la imágen que vez a continuación es de una red dentro del MIT donde los estudiantes pueden compartirse archivos. Según la web oficiales, esta red no está vigilada por el MIT, por lo cual ellos no pueden responsabilizarse ni borrar nada de lo que sus usuarios suban.
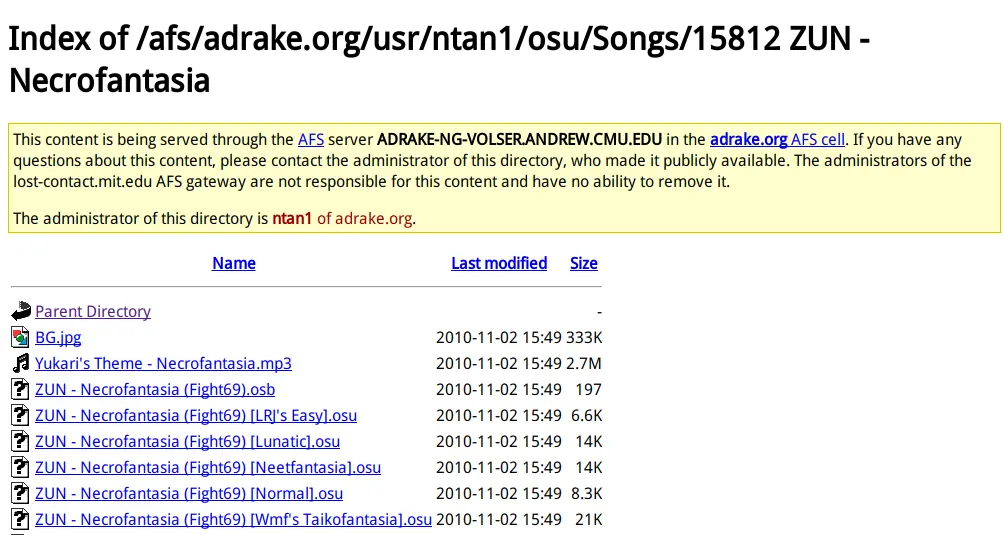
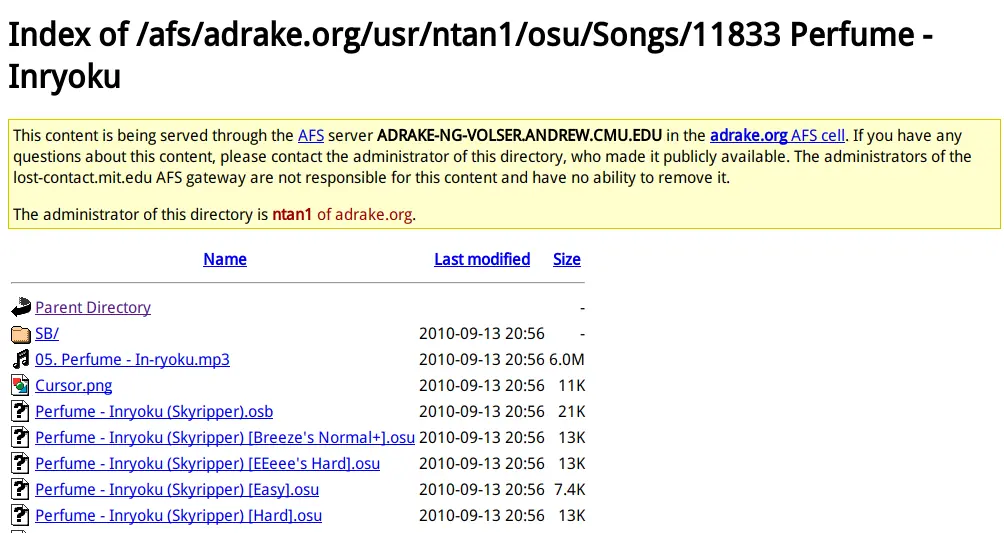
No dejo link directo, porque T! tiene una política opositora a los enlaces de descarga, y me puedo comer tremendo BAN. Además algunos de los "Estudiantes" comparten material pirata. Desde libros y manuales educativos, hasta música japonesa. Como lo ha hecho este/a chic@:
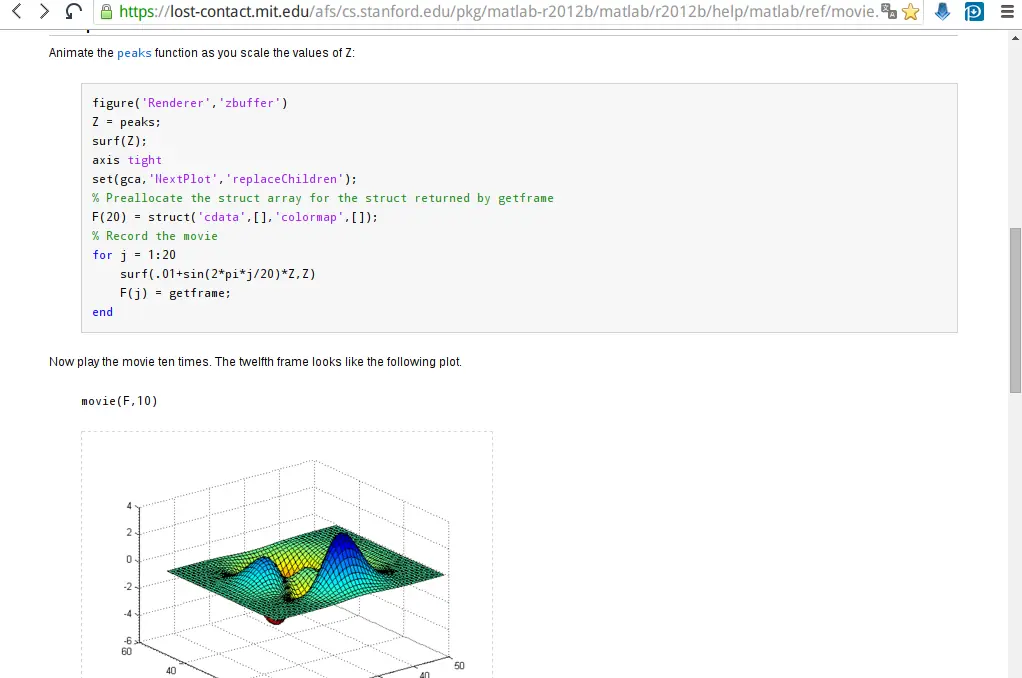
Aunque hay gente que lo usa también para proyectos personales y analíticos (Que de hecho es para lo que creo que el MIT pensó originalmente esta red):
También hay películas (En inglés), y software profesional. Aunque no me fío de lo último. Esta red forma parte de la Deep Web, ya que no toda la información perteneciente a ella llega a ser indexada.
De vez en cuando Google puede tomar fracciones de la Deep Web. Esto pasa cuando sale por ejemplo la descripción "(...) No hay descripciones de este resultado disponibles debido al archivo robots.txt de este sitio (...)"
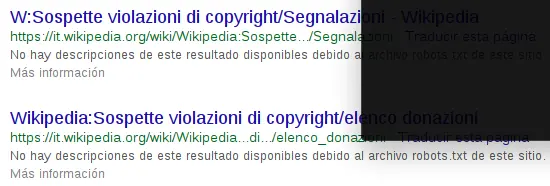
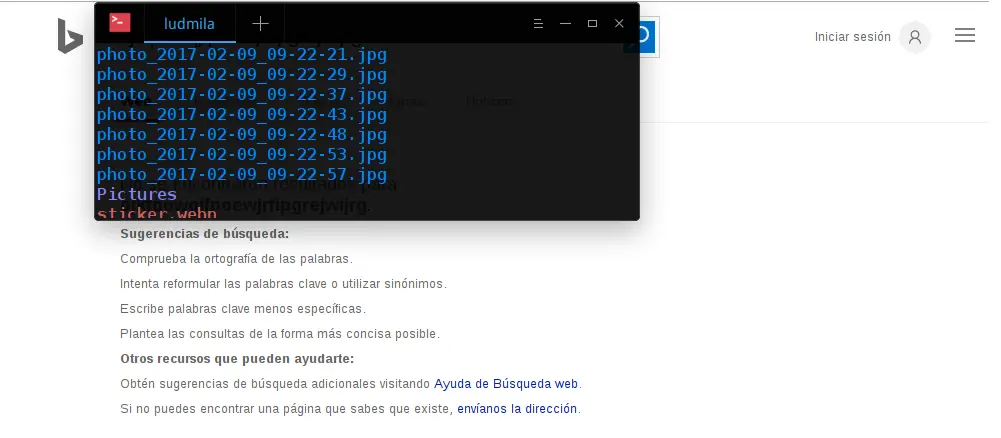
De hecho, si conocemos los bots que se encuentran censurados, puede usarse Google como puerta de acceso. Lo curioso, es que mientras que a Google le vale madres la petición de no indexar archivos protegidos por robots.txt, ellos la indexan igual, pero sin información de contenido. Bing lo hace mejor, y directamente no te arroja los resultados.
Para buscar información en la Deep Web. Algunas páginas recomendadas son:
> Contiene libros de medicina, militares, medicina, etc. Es bastante completo.
> Buscador de artículos científicos.
> http://vlib.org/ Una biblioteca virtual.
> http://www.infoplease.com/ Busca en varios sitios. Sobre todo enciclopedias.
> http://www.ipl.org/ Un buscador creado por la universidad de Michigan para la búsqueda de recursos didácticos.
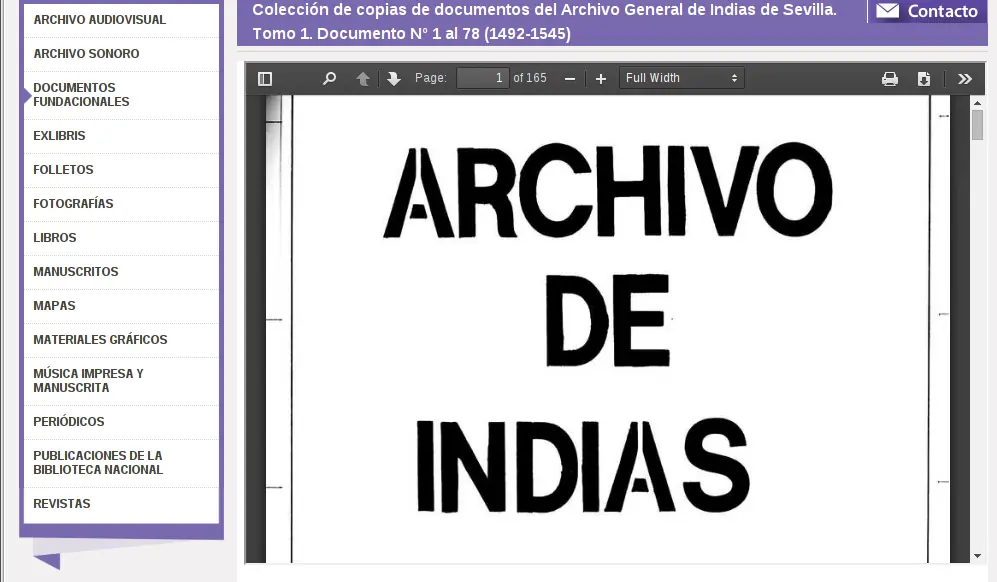
> La Biblioteca Nacional Argentina, al igual que muchas bibliotecas nacionales, posee un amplio catalogo de documentos antiguos. Normalmente esta clase de archivos tampoco son indexados por buscadores como Google. Lo que es una mala noticia, ya que vienen de lujo para los estudiantes de Historia que apenas inicien su carrera.
> Busca documentos científicos en varios formatos e idiomas.
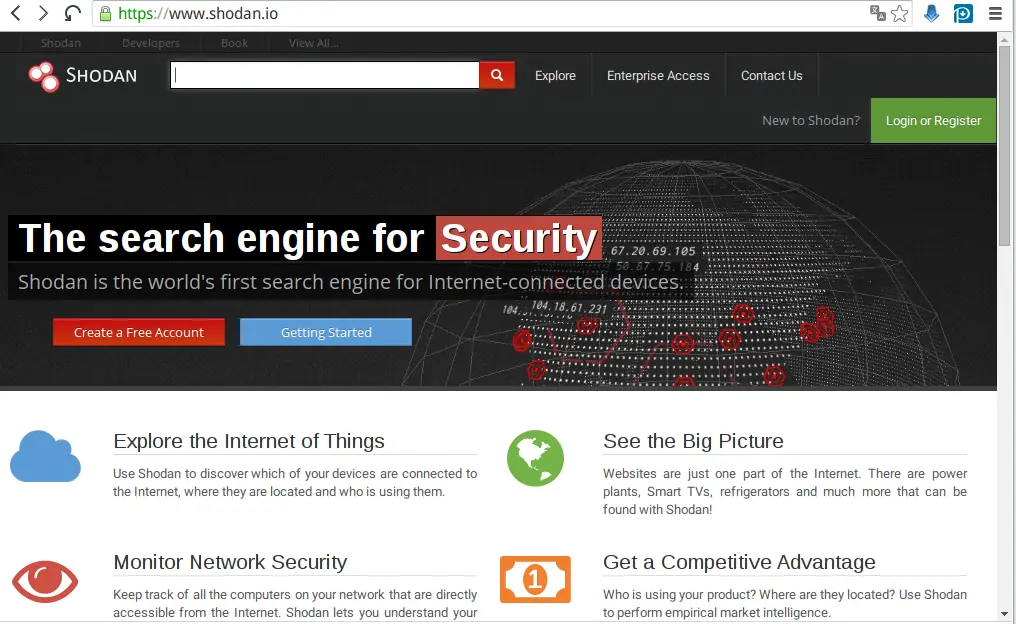
> https://www.shodan.io/ Permite buscar equipos conectados a internet. Desde Webcams hasta routers. Ahora ya sabes porque no debes usar contraseñas por defecto.
> https://brightplanet.com/ Recolecta datos de la Deep Web. Pero es un servicio pago
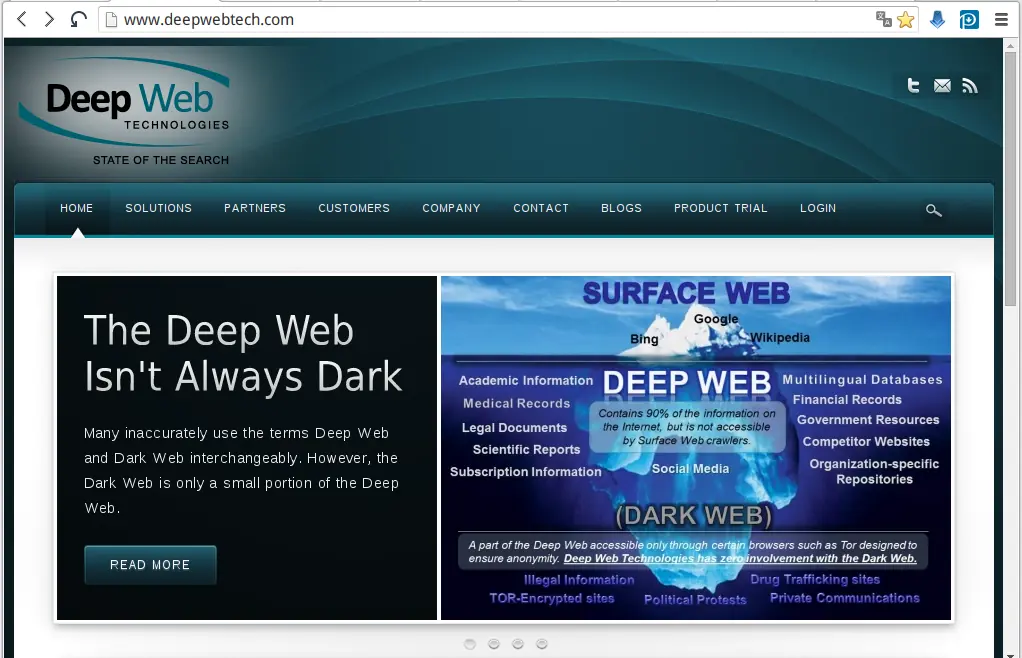
Por supuesto, la Deep Web también incluye redes VPN como TOR. Pero no son lo mismo, ya que la información que TOR posee es mucho menor e insignificante que la Deep Web. Después de todo sólo es una fracción de ella. Compararlos es como comparar el agua de un grifo con las Cataratas del Niágara.
He visto también a mucha gente que dice haber entrado a TOR y por eso sabe que la información es mayor en la web superficial. No obstante lo dicen por ignorancia, así que les perdono. Sin embargo, eso nos lleva a una de las incógnitas del internet. ¿De donde sale la comparación de la Deep web con el oceano?. Esa respuesta sale de un estudio del año 2001 realizado por brightplanet, donde se analizaba como funcionaba el internet, explicando porque no podíamos acceder realmente a todo su banco de datos. Usando los procesos de KDD ( https://goo.gl/ZfCznd ), llegan a la conclusión de que el total de datos en el año 2000 que se encontraba en la surface era sólo del 0,03%. De hecho, puedes leer ese estudió en esta web ( https://goo.gl/6wamD ). Dicho sea de paso, tiene legitimidad científica. Aunque actualmente se encuentre desactualizado.
Respecto a la Deep Web, BrightPlanet ha publicado además una explicación sobre que es la Deep Web, y cual es su diferencia con la Dark Web. Mientras que la primera sólo es información no indexada, la segunda son Webs ilegales que no se encuentran indexadas. El hecho de esta explicación se dio cuando un reportero confundió la Deep Web con la Dark Web, y acusó a la compañía BrightPlanet de buscar y compartir información ilegal. Por tanto tuvieron que salir a explicar lo que realmente significaba Deep Web, ya que muchos asociaban el término a la venta de drogas. Puedes ver la publicación de BrightPlanet aquí ( https://goo.gl/Jhva5T ). Donde también se aclara que la Dark Web es sólo una pequeña porción de la Deep Web.
Ahora ya sabes lo que realmente significa Deep Web, y que los gobiernos no dejan sus datos en TOR. Este mito surgió por una comprensión errónea. Pues como habrán leído anteriormente, los documentos de las bibliotecas nacionales, generalmente no suelen estar indexados. Así que forman parte de la Deep Web. Esa puede ser la explicación al mito de "Todos los gobiernos poseen archivos en la Deep Web". Eso es absolutamente cierto, pero tampoco crean que son archivos super-secretos. Muchos de ellos son de dominio público y los puede consultar cualquier persona que encuentre o posea el enlace. Tampoco te va a caer el FBI a tu casa por ver fotos de las cartas de Belgrano (Argentina), o leer las citas escritas por Abraham Lincoln (USA). Espero que el post les haya sido útil.

Lo principal es comprender que si bien TOR, Freenet, I2P, y demás redes anónimas forman parte de la Deep Web, no son el contenido total de la Deep Web. De hecho para ingresar a gran parte del contenido en la internet profunda ni siquiera se necesita de software especializado.
La Deep Web se trata sólo de información no indexada por los motores de búsqueda convencionales. Lo cual significa que normalmente no indexará sitios protegidos por "Robots.txt" ( https://goo.gl/5j33zO ). Así como también las "Redes de entrega de contenido" (CDN, por sus siglas en inglés). En resumen, los buscadores no indexan Links ocultos, o webs de acceso dinámico. Dicho en palabras simples: "Sólo se puede acceder a ellos al cumplirse ciertas reglas".
Veamos un ejemplo. Para evitar hackers una web puede utiliza un cdn. Especialmente si se trata de una web comercial. Entonces, por ejemplo, si abrimos una imagen con un link de la página (Abrir imagen en...), podremos verla, pero si copiamos el link de esa misma imagen e intentamos abrirla en otra pestaña, nos saldrá un cartel de error. Esto sucede porque sólo se puede acceder a esas imágenes si las mismas son abiertas desde la web principal. Si no se cumple este requerimiento, simplemente no se puede ingresar aunque el link esté correcto. Este mismo motivo evita que los contenidos cdn de ciertas páginas web no sean indexadas por los buscadores, ya sean imágenes, libros, audios, y cualquier otro tipo de archivos. Este truco suele usarse mucho en webs de venta. Lo que es lógico, ya que si una página que vende software, te permitiera ingresar al sitio de descarga del software pago desde Google, es probable que muchos no paguen por el servicio. Sin mencionar que todos tendríamos Software legal, versión Pro, absolutamente gratis. Además de tener gratis también los supuestos manuales que te venden sobre como estirarte el amigo (Si eres hombre), o como masajearte los pechos para que se te crezcan (Si eres mujer). Sí, esos manueles existen, y están a la venta, pueden buscarlo si no me creen.
En el año 2014 se estimó que el tamaño de la Deep Web era de 90k TB. Gran parte de su contenido proviene de Universidades. Por ejemplo, la imágen que vez a continuación es de una red dentro del MIT donde los estudiantes pueden compartirse archivos. Según la web oficiales, esta red no está vigilada por el MIT, por lo cual ellos no pueden responsabilizarse ni borrar nada de lo que sus usuarios suban.
No dejo link directo, porque T! tiene una política opositora a los enlaces de descarga, y me puedo comer tremendo BAN. Además algunos de los "Estudiantes" comparten material pirata. Desde libros y manuales educativos, hasta música japonesa. Como lo ha hecho este/a chic@:
Aunque hay gente que lo usa también para proyectos personales y analíticos (Que de hecho es para lo que creo que el MIT pensó originalmente esta red):
También hay películas (En inglés), y software profesional. Aunque no me fío de lo último. Esta red forma parte de la Deep Web, ya que no toda la información perteneciente a ella llega a ser indexada.
De vez en cuando Google puede tomar fracciones de la Deep Web. Esto pasa cuando sale por ejemplo la descripción "(...) No hay descripciones de este resultado disponibles debido al archivo robots.txt de este sitio (...)"
De hecho, si conocemos los bots que se encuentran censurados, puede usarse Google como puerta de acceso. Lo curioso, es que mientras que a Google le vale madres la petición de no indexar archivos protegidos por robots.txt, ellos la indexan igual, pero sin información de contenido. Bing lo hace mejor, y directamente no te arroja los resultados.
Para buscar información en la Deep Web. Algunas páginas recomendadas son:
> Contiene libros de medicina, militares, medicina, etc. Es bastante completo.
> Buscador de artículos científicos.
> http://vlib.org/ Una biblioteca virtual.
> http://www.infoplease.com/ Busca en varios sitios. Sobre todo enciclopedias.
> http://www.ipl.org/ Un buscador creado por la universidad de Michigan para la búsqueda de recursos didácticos.
> La Biblioteca Nacional Argentina, al igual que muchas bibliotecas nacionales, posee un amplio catalogo de documentos antiguos. Normalmente esta clase de archivos tampoco son indexados por buscadores como Google. Lo que es una mala noticia, ya que vienen de lujo para los estudiantes de Historia que apenas inicien su carrera.
> Busca documentos científicos en varios formatos e idiomas.
> https://www.shodan.io/ Permite buscar equipos conectados a internet. Desde Webcams hasta routers. Ahora ya sabes porque no debes usar contraseñas por defecto.
> https://brightplanet.com/ Recolecta datos de la Deep Web. Pero es un servicio pago
Por supuesto, la Deep Web también incluye redes VPN como TOR. Pero no son lo mismo, ya que la información que TOR posee es mucho menor e insignificante que la Deep Web. Después de todo sólo es una fracción de ella. Compararlos es como comparar el agua de un grifo con las Cataratas del Niágara.
He visto también a mucha gente que dice haber entrado a TOR y por eso sabe que la información es mayor en la web superficial. No obstante lo dicen por ignorancia, así que les perdono. Sin embargo, eso nos lleva a una de las incógnitas del internet. ¿De donde sale la comparación de la Deep web con el oceano?. Esa respuesta sale de un estudio del año 2001 realizado por brightplanet, donde se analizaba como funcionaba el internet, explicando porque no podíamos acceder realmente a todo su banco de datos. Usando los procesos de KDD ( https://goo.gl/ZfCznd ), llegan a la conclusión de que el total de datos en el año 2000 que se encontraba en la surface era sólo del 0,03%. De hecho, puedes leer ese estudió en esta web ( https://goo.gl/6wamD ). Dicho sea de paso, tiene legitimidad científica. Aunque actualmente se encuentre desactualizado.
Respecto a la Deep Web, BrightPlanet ha publicado además una explicación sobre que es la Deep Web, y cual es su diferencia con la Dark Web. Mientras que la primera sólo es información no indexada, la segunda son Webs ilegales que no se encuentran indexadas. El hecho de esta explicación se dio cuando un reportero confundió la Deep Web con la Dark Web, y acusó a la compañía BrightPlanet de buscar y compartir información ilegal. Por tanto tuvieron que salir a explicar lo que realmente significaba Deep Web, ya que muchos asociaban el término a la venta de drogas. Puedes ver la publicación de BrightPlanet aquí ( https://goo.gl/Jhva5T ). Donde también se aclara que la Dark Web es sólo una pequeña porción de la Deep Web.
Ahora ya sabes lo que realmente significa Deep Web, y que los gobiernos no dejan sus datos en TOR. Este mito surgió por una comprensión errónea. Pues como habrán leído anteriormente, los documentos de las bibliotecas nacionales, generalmente no suelen estar indexados. Así que forman parte de la Deep Web. Esa puede ser la explicación al mito de "Todos los gobiernos poseen archivos en la Deep Web". Eso es absolutamente cierto, pero tampoco crean que son archivos super-secretos. Muchos de ellos son de dominio público y los puede consultar cualquier persona que encuentre o posea el enlace. Tampoco te va a caer el FBI a tu casa por ver fotos de las cartas de Belgrano (Argentina), o leer las citas escritas por Abraham Lincoln (USA). Espero que el post les haya sido útil.